UniForge3D реконструирует 3D-объект по разреженным снимкам без известных поз камеры: сохраняет видимую геометрию и достраивает невидимые области на основе выученных закономерностей. Метод учитывает, что реконструкция идёт в системе координат камеры, а генерация — в каноническом пространстве; также он отбирает полезные виды, чтобы лишняя информация не мешала мелким деталям. Заявлен SOTA по внешнему виду и геометрии на Toys4K и GSO.
AlayaLab представила MeshAxiom — открытый 3D-стек для агентов. Модель MeshAxiom-Base строит компактный явный меш по одному изображению с заданным числом граней. Вершины и треугольники сохраняются в файле, чтобы с геометрией могли работать инструменты.
Агент может вызывать инструменты для работы с геометрией и получать компактные сводки и виды. Записи ассетов связывают геометрию и материалы с трансформами, ригами и движением; из таких модулей собираются сцены и сценарные программы. Готовую сцену можно дополнительно рестайлизовать через H3.
3DCodeVerse помогает агентам создавать кодом статичные и артикулированные 3D-объекты, сцены, миры и анимацию. Результат — редактируемая и проверяемая программа, а не готовый меш.
В экосистему входят 3DCodeVerse-2M с 2 млн исполняемых 3D-программ, исходниками, ассетами, описаниями и записями проверок; мультиагентный 3DCodeVerse Harness, который проверяет исполнение, измеряет пространство, анализирует рендеры и исправляет программу; а также рекомендации по итогам экспериментов. В парных оценках людьми система одержала 90% побед над Claude Design (3D Object); обе стороны работали через Claude.
GaussFusion — проект Stanford и Zillow Group для CVPR 2026. Он исправляет готовые 3DGS-реконструкции: убирает летающие точки, мерцание и размытие, возникающие из-за ошибок позы камеры и неполного покрытия. Сцену не переобучают — модель улучшает рендер. Метод работает с оптимизационными подходами и прямыми методами, включая DepthSplat.
Из реконструкции рендерят буфер с цветом, глубиной, нормалями, непрозрачностью и ковариацией гауссиан. VAE и трёхмерная свёртка сжимают его в латент геометрии. Flow-трансформер на блоках DiT с геометрическими адаптерами соединяет его с латентом видео; текст поступает через cross-attention. На выходе — согласованные по времени кадры без артефактов. Быстрый вариант работает на 16 FPS. Код и модель пока ожидаются.
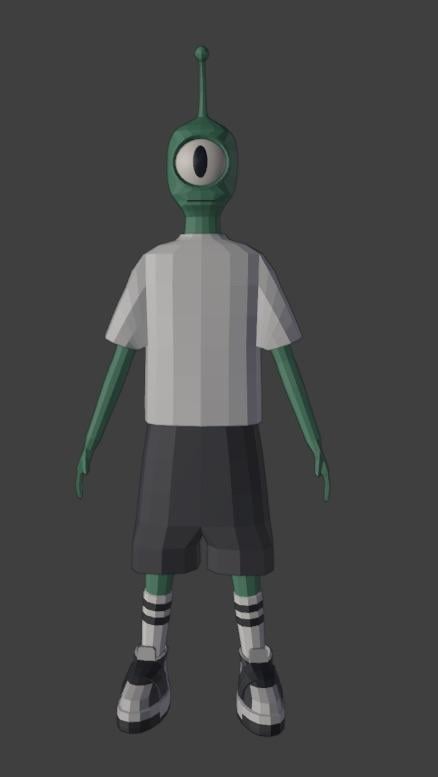
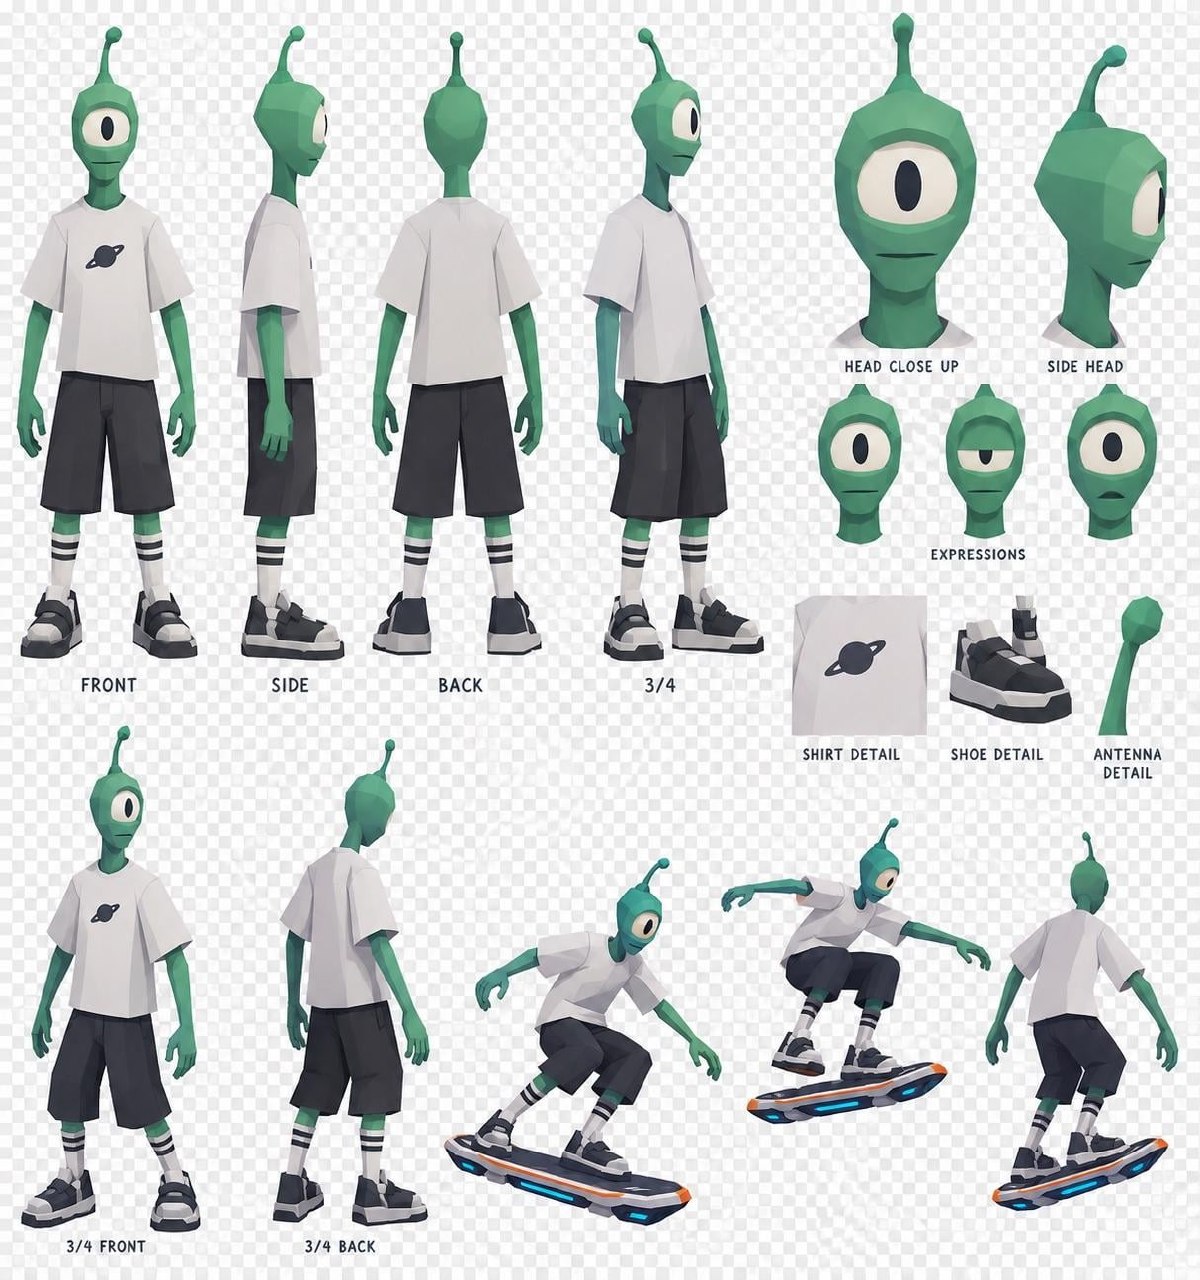
A step-by-step workflow uses ChatGPT, Opus 5.5, and Blender for character design and 3D asset creation. It includes Blender skills and personalized prompts for rigging and preparing animations.
A project to build a local tool that turns images into 3D game assets, aiming to improve asset quality and reduce reliance on paid external services. The planned interface includes image uploads, asset-refinement controls, and integration with game development environments.
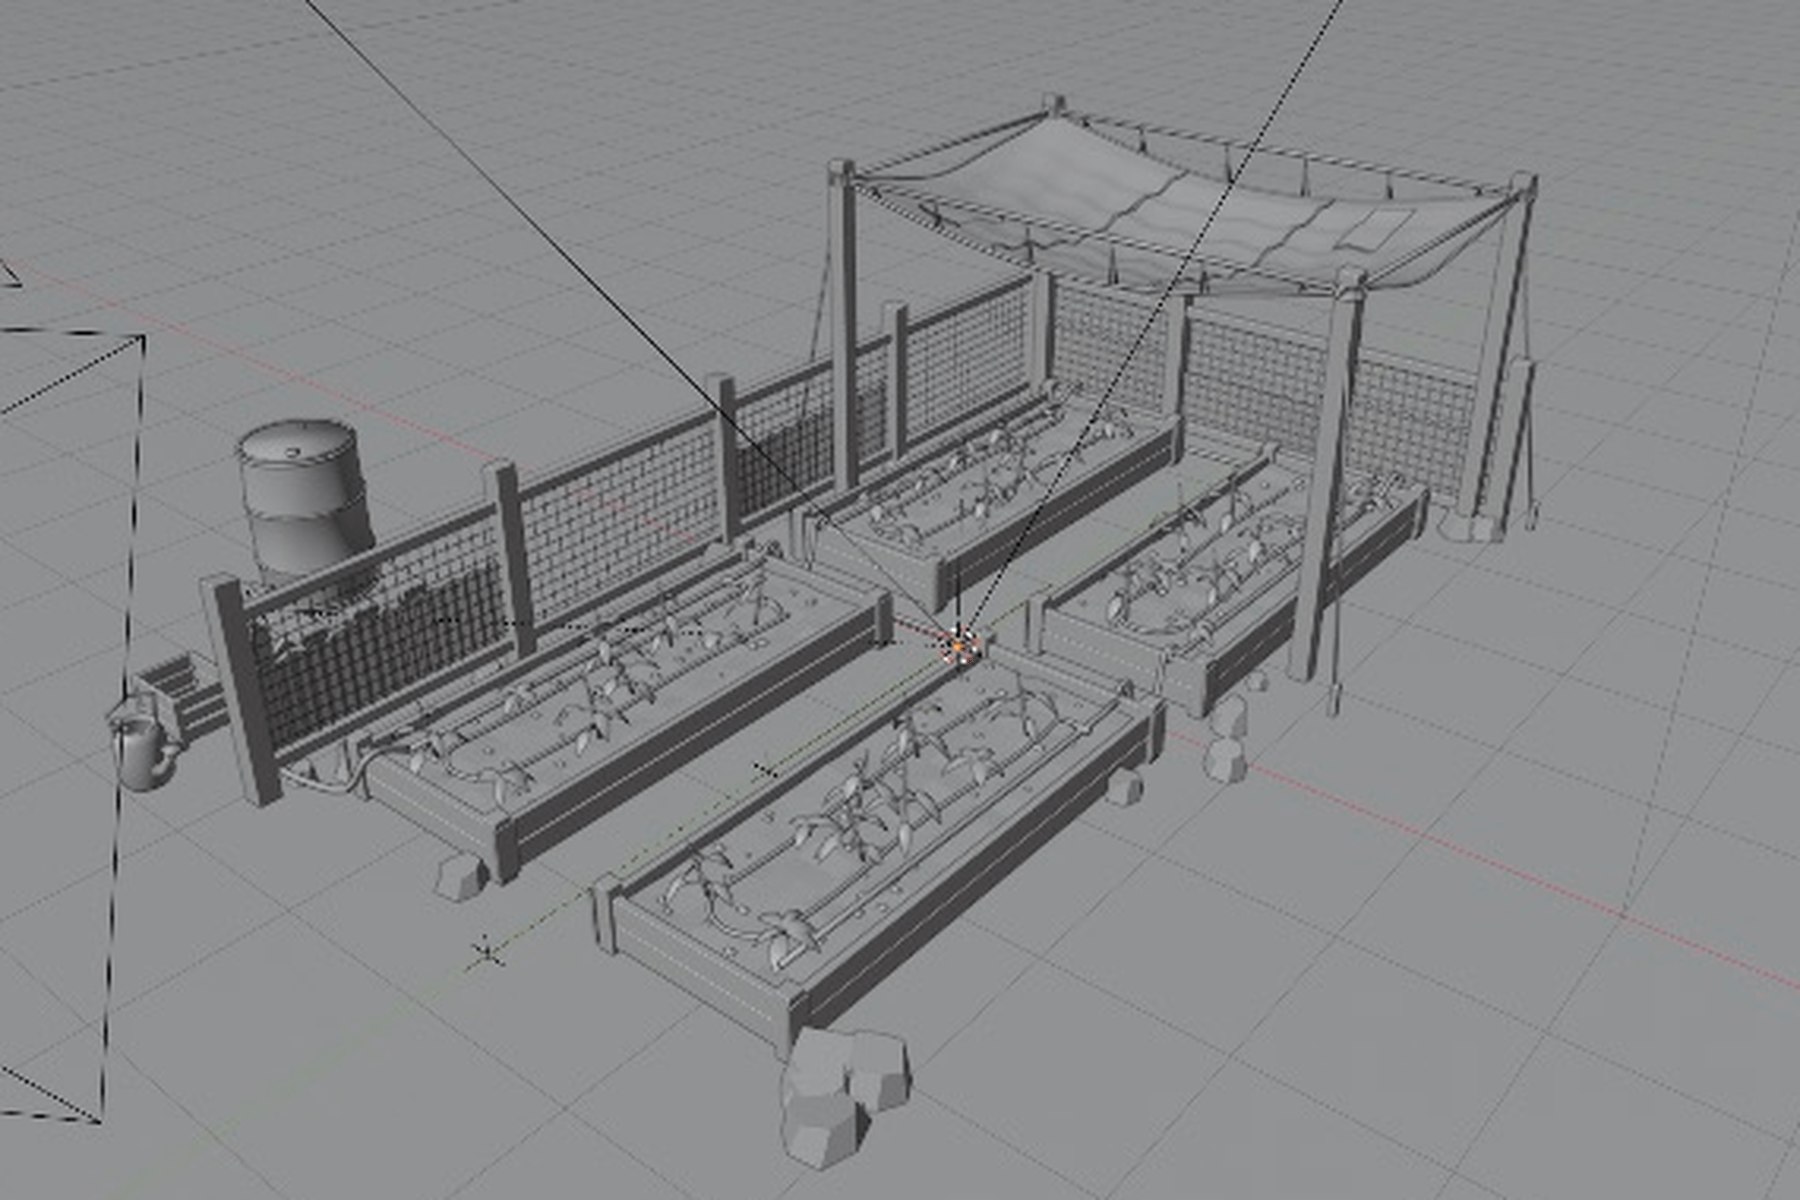
Blender Asset Studio is a GitHub-available workflow for reference-based modeling through Blender MCP, using tools such as Codex and Opus. It checks proportions, materials, construction, and intersecting parts from multiple angles, then logs defects for targeted fixes. The workflow also sets triangle, material, and texture budgets and verifies GLB exports by reimporting them.
Mago Local собирает в десктопном приложении генерацию фильма по идее или сценарию, покадровую либо целую перестилизацию своего материала и редактор с шотами, слоями и AI-рендерами на одном таймлайне. Приложение хранит проекты, эпизоды, шоты и рендеры и подсчитывает экономию локального рендера по сравнению с облаком.
Локальный стек включает Qwen3.8-27B для текста, Qwen3-VL для анализа изображений и видео, Qwen 2511 image/edit или Flux 2 dev для персонажей и фонов, MiniMax H3 ref2va для видео в вариантах на 4 и 8 шагов. Нужны Windows, NVIDIA с VRAM от 16 ГБ и 60 ГБ на диске. Приложение работает с любым сервером ComfyUI, включая RunPod и Vast.ai, а при необходимости устанавливает ComfyUI само. Облачные модели остаются доступны; код обещают открыть.
VAST выпустила EdenLive: модель превращает черновой прокси-поток из 2D- или 3D-сцены, игрового движка либо записи в готовое видео. На вход также подаются первый кадр и текстовый промпт. Внешний код управляет состоянием сцены и взаимодействием, а модель отвечает за изображение.
Признаки прокси-кадров извлекает дообученный кодировщик DINOv3 и передаёт их диффузионному трансформеру. Есть ветка 14B на Wan2.1 I2V для 480p и ветка 5B на Wan2.2 для 720p; у каждой — двунаправленный и потоковый режимы. Поток собирается чанками по 4 шага, декодер TAEHV обеспечивает 24 FPS и выше. Есть демо на несколько минут; версия 5B в 720p работает на одной видеокарте.
Все компоненты занимают около 210 ГБ и лежат в одной папке. Блок на FLUX.2 klein нужен только для генерации первого кадра в реальном времени; его лицензия — некоммерческая.
ComfyUI Portable v0.41.0 adds fixes and support for MiniMax-H3 LightVAE and MOSS-Image with typography accuracy. Other tools include VoiceShaper for vocal controls, ClipColorAnchor for video color drift, StacyLoop for loops with hand-aware masking, and an image-restyle helper. An updated 1980s Horror Movies LoRA v2 and a storyboard workflow tutorial are also available.
A MiniMax H3 Ref2VA prompt structure defines characters with reference images and tags for video character replacement while keeping the original environment and audio. Another LoRA is described as supporting diverse inputs, improving smoothness and versatility, and taking 5.2 seconds to process.
A tutorial covers blending AI-generated animation, keeping characters consistent and correctly placed, and reducing unwanted objects and effects. It also discusses simpler prompt language and using game mechanics to shape the visuals.
This workflow brings together a seamless video combiner, a Minimax continuous audio splitter, an H3 Clown anchoring node, and a ComfyUI node for loading batches of audio from a directory.
H3 Recast is an open-source workflow for swapping up to three people in a video clip in one pass while retaining motion and audio. Optional FaceRefine lip repair improves lip synchronization; the workflow also references the BFS face-swap LoRA and NativeAudioLock.
The stated requirements for optimal performance are 16 GB VRAM and 64 GB system RAM. The GitHub repository includes example inputs.
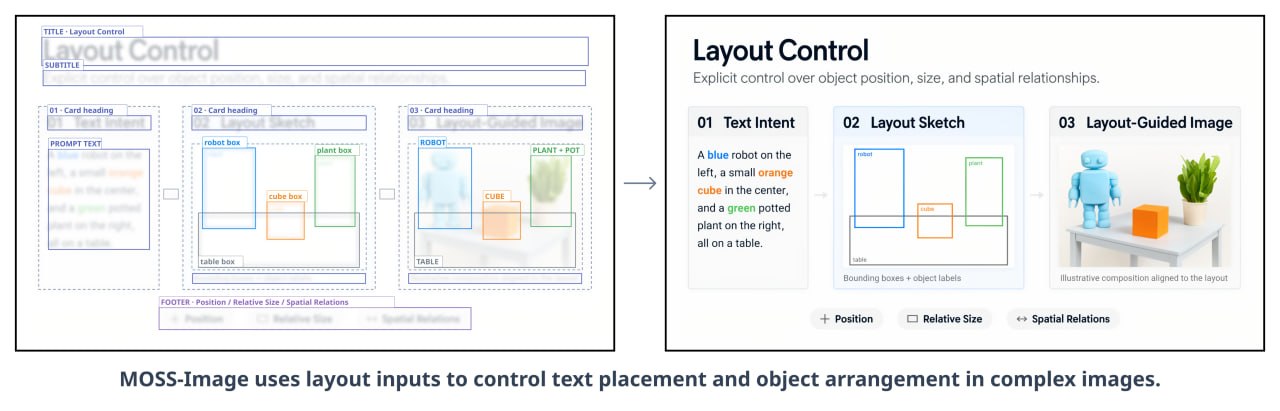
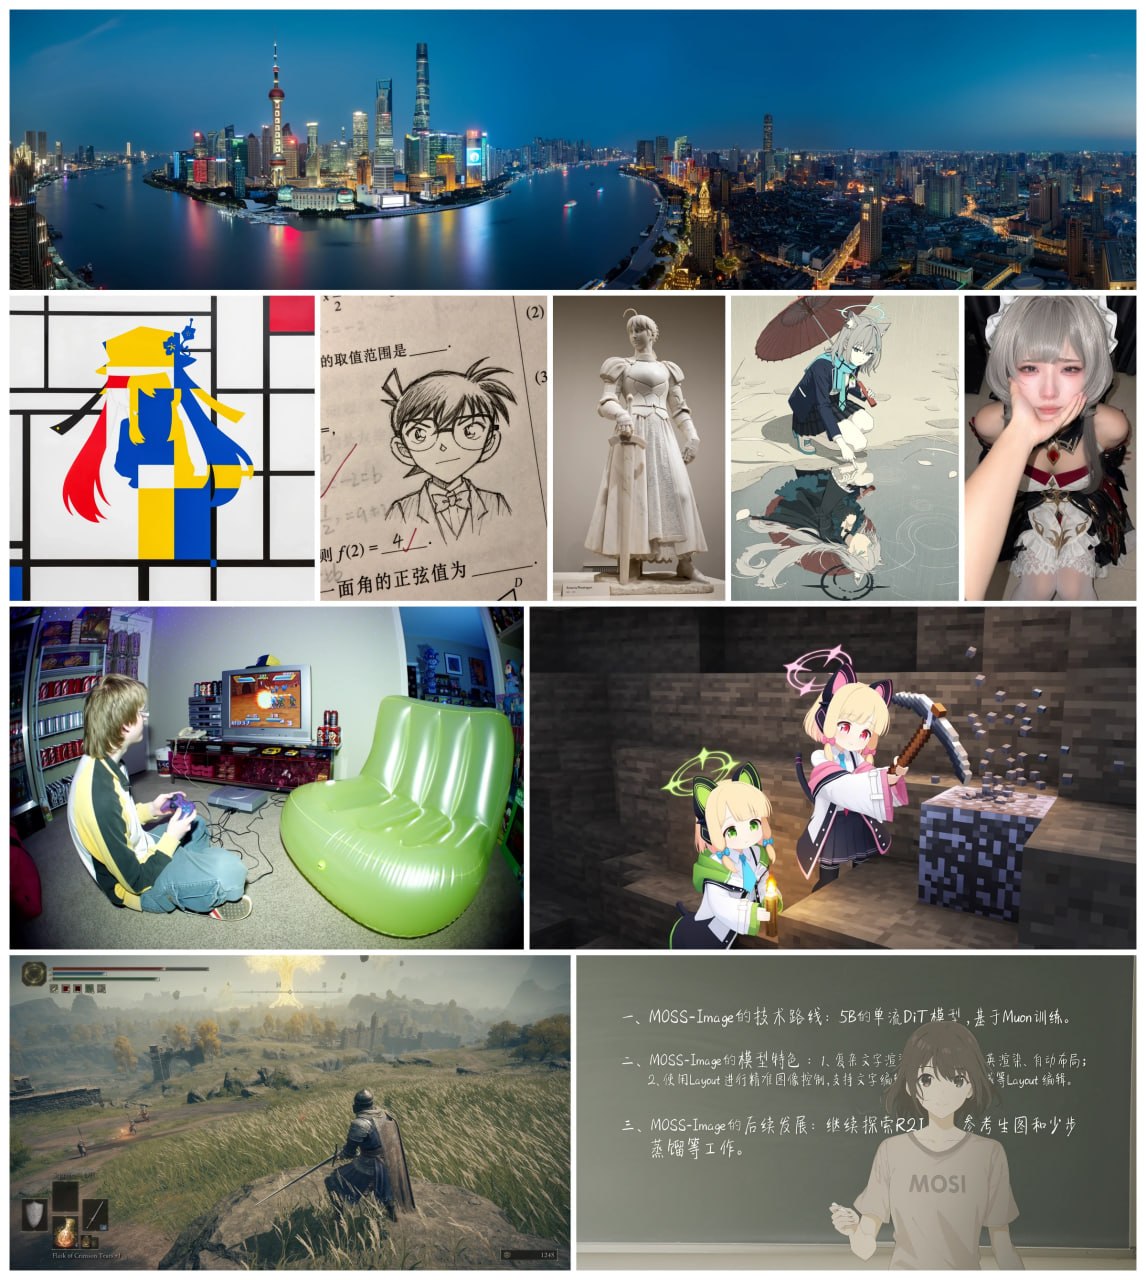
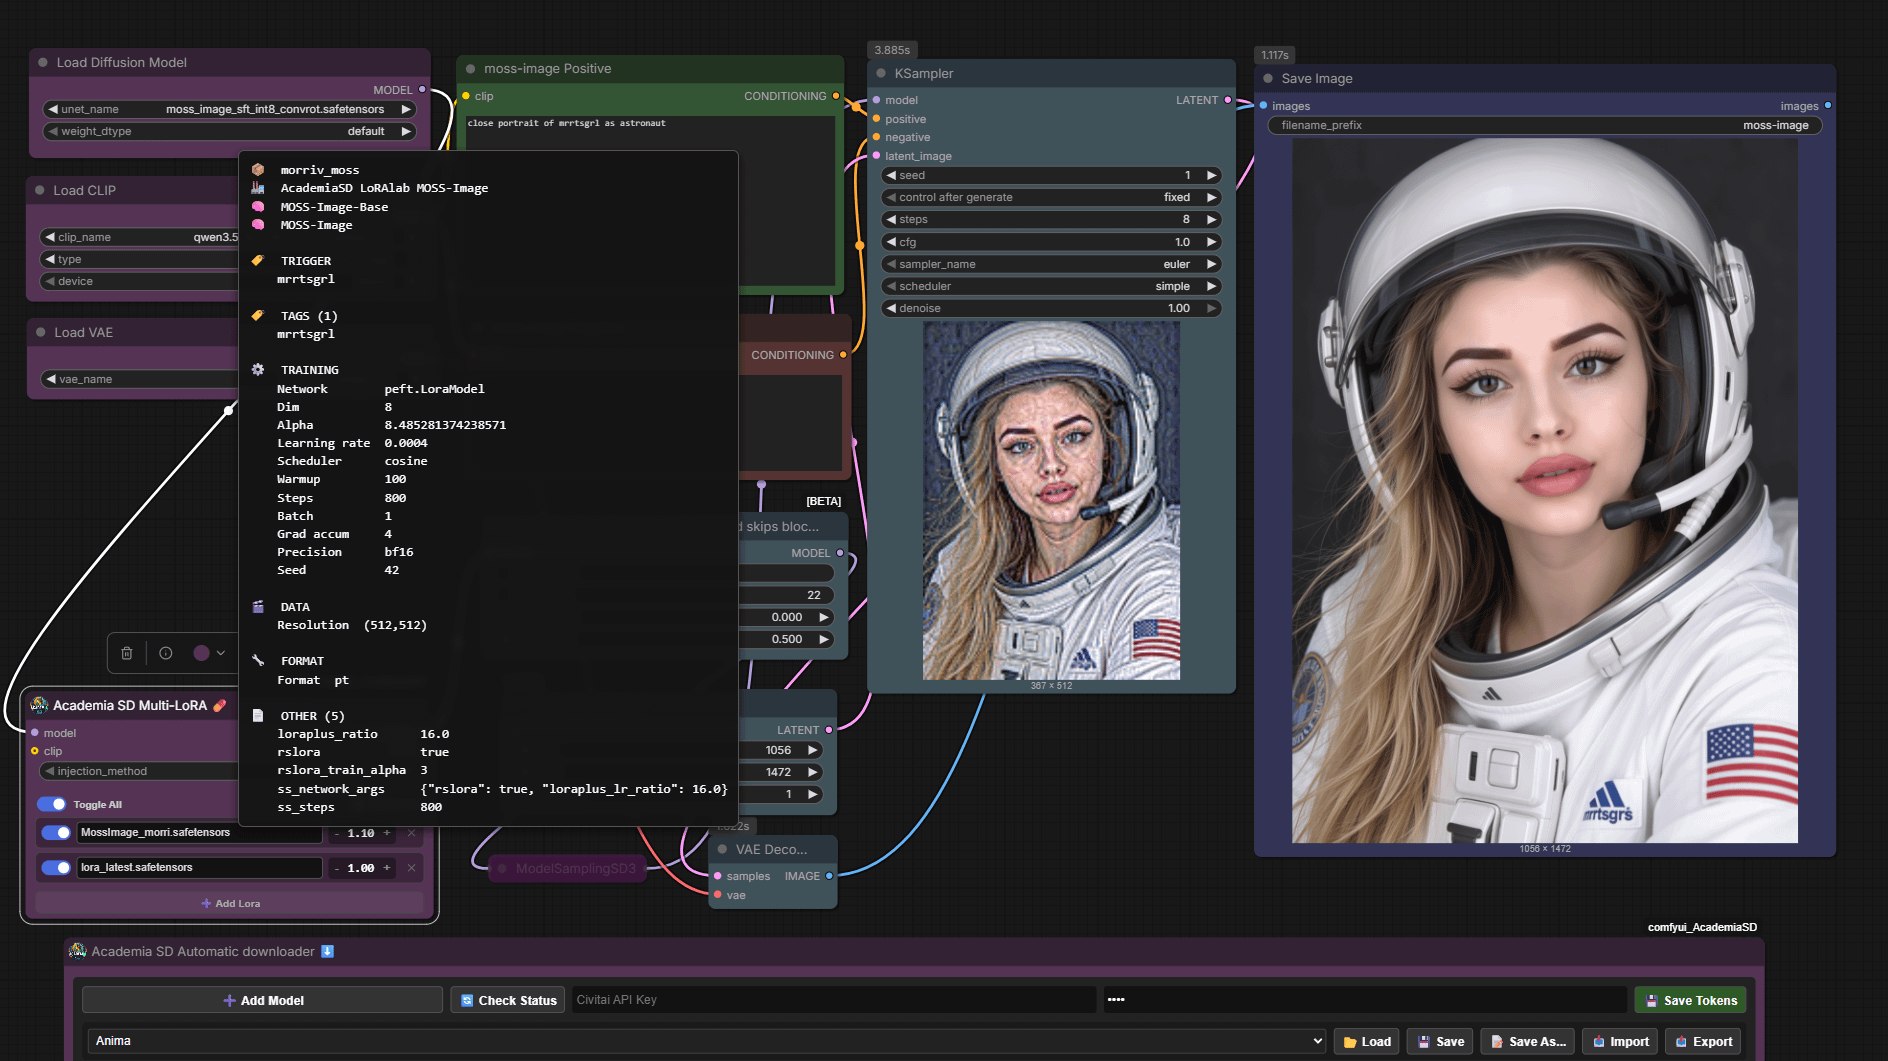
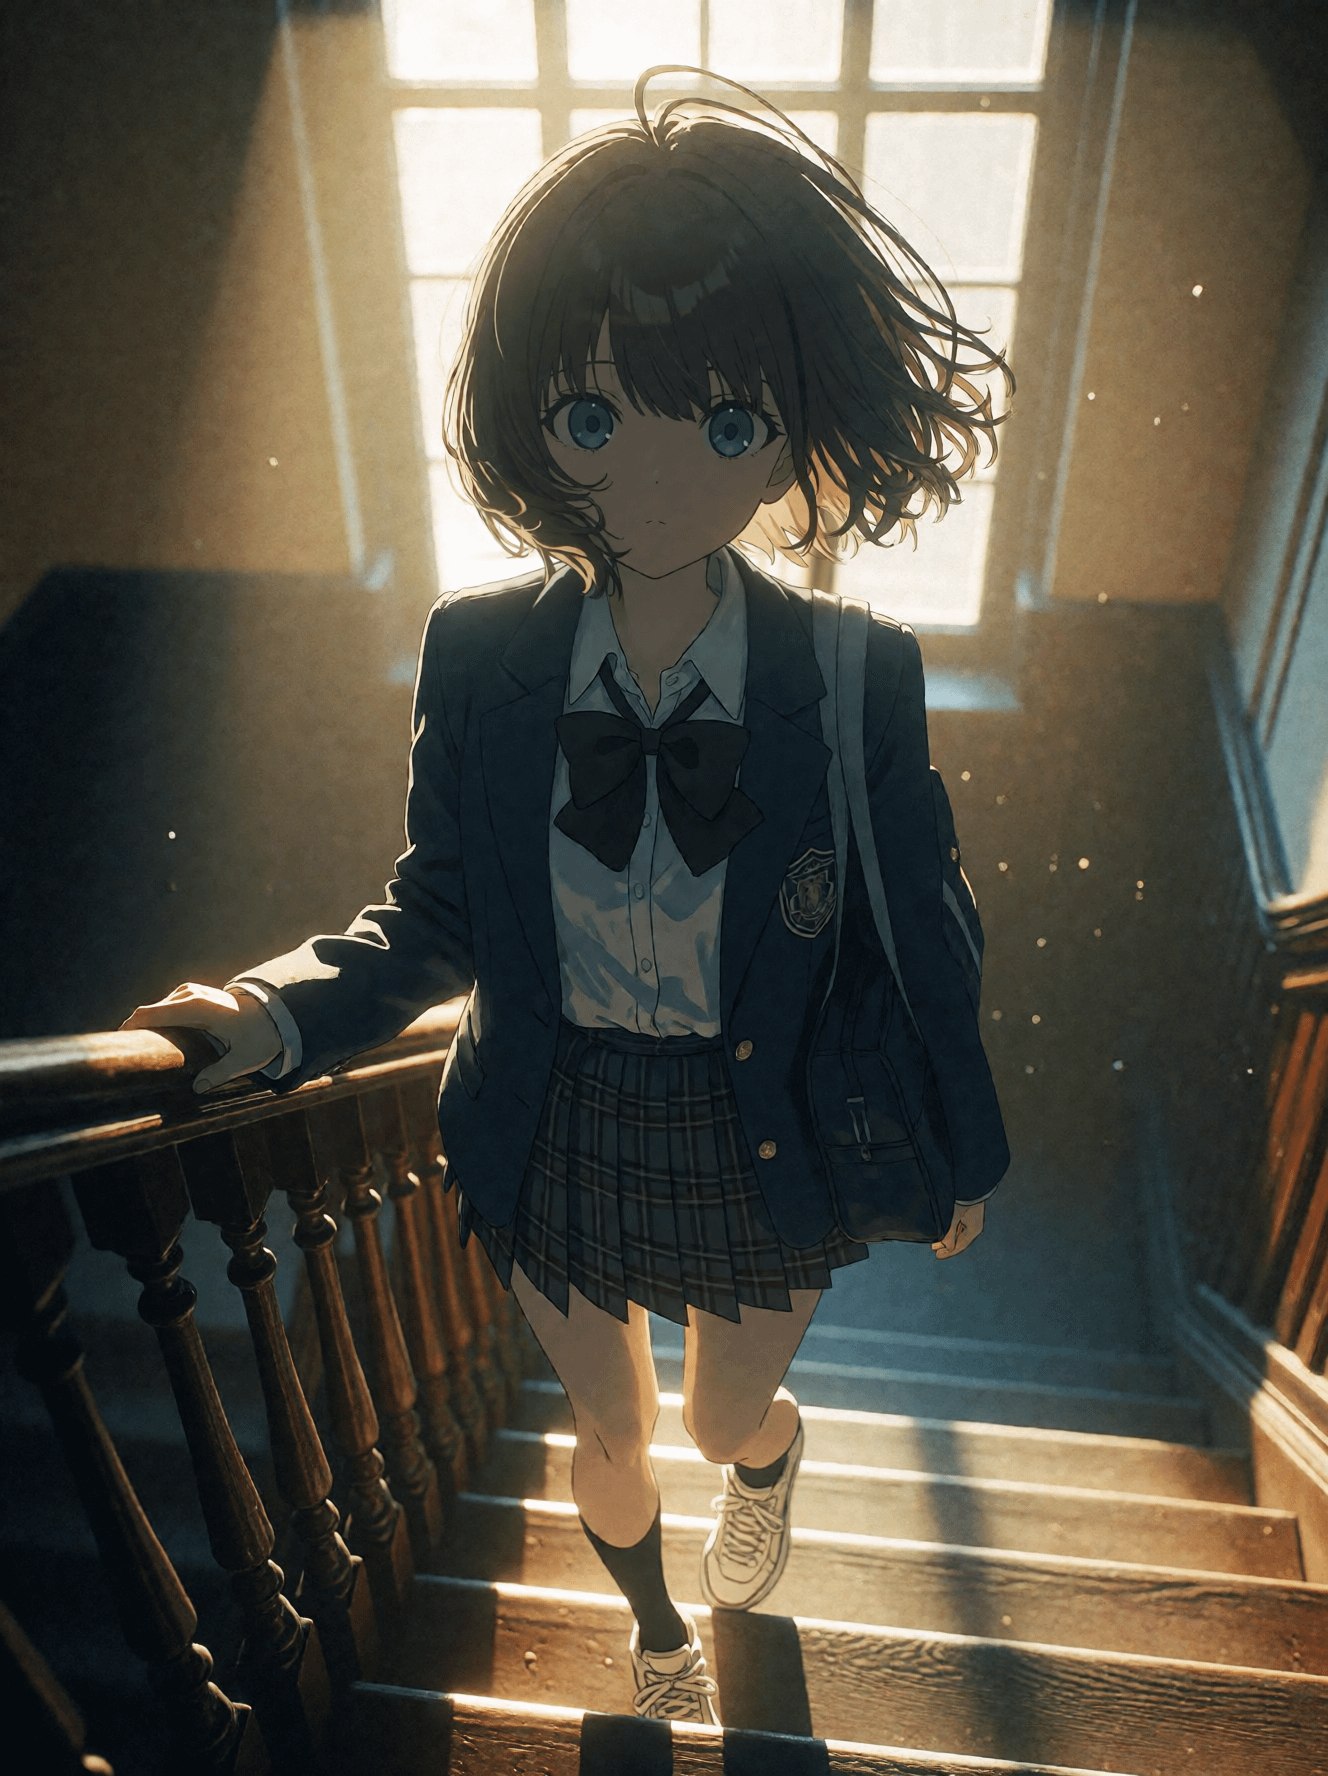
MOSS-Image — открытая DiT-модель на 5B параметров с весами под Apache-2.0. Она генерирует изображения по тексту или структурированному JSON: в нём можно задать объекты, надписи и их рамки, а затем править сцену через описания и боксы. Модель ориентирована на текст внутри изображений, включая китайский и рукописные надписи; поддерживает промпты до 4K токенов. Указанные настройки генерации — 50 шагов, CFG 3, flow-matching Euler, shift 5 и пропуск негативной ветки на слое 22.
В AMA разработчик рассказал, что модель делали полгода, а сборка для ComfyUI набрала более 354 тысяч скачиваний. На коротких промптах результат сильно зависит от сида; на длинных, по его словам, один и тот же сид позволяет менять описание почти как при редактировании. Команда планирует аниме-версию, обсуждает Edit-модель и вариант XL на 10–12 млрд параметров. Автор канала советует Base вместо SFT из-за полос на изображениях и характерного стиля SFT.
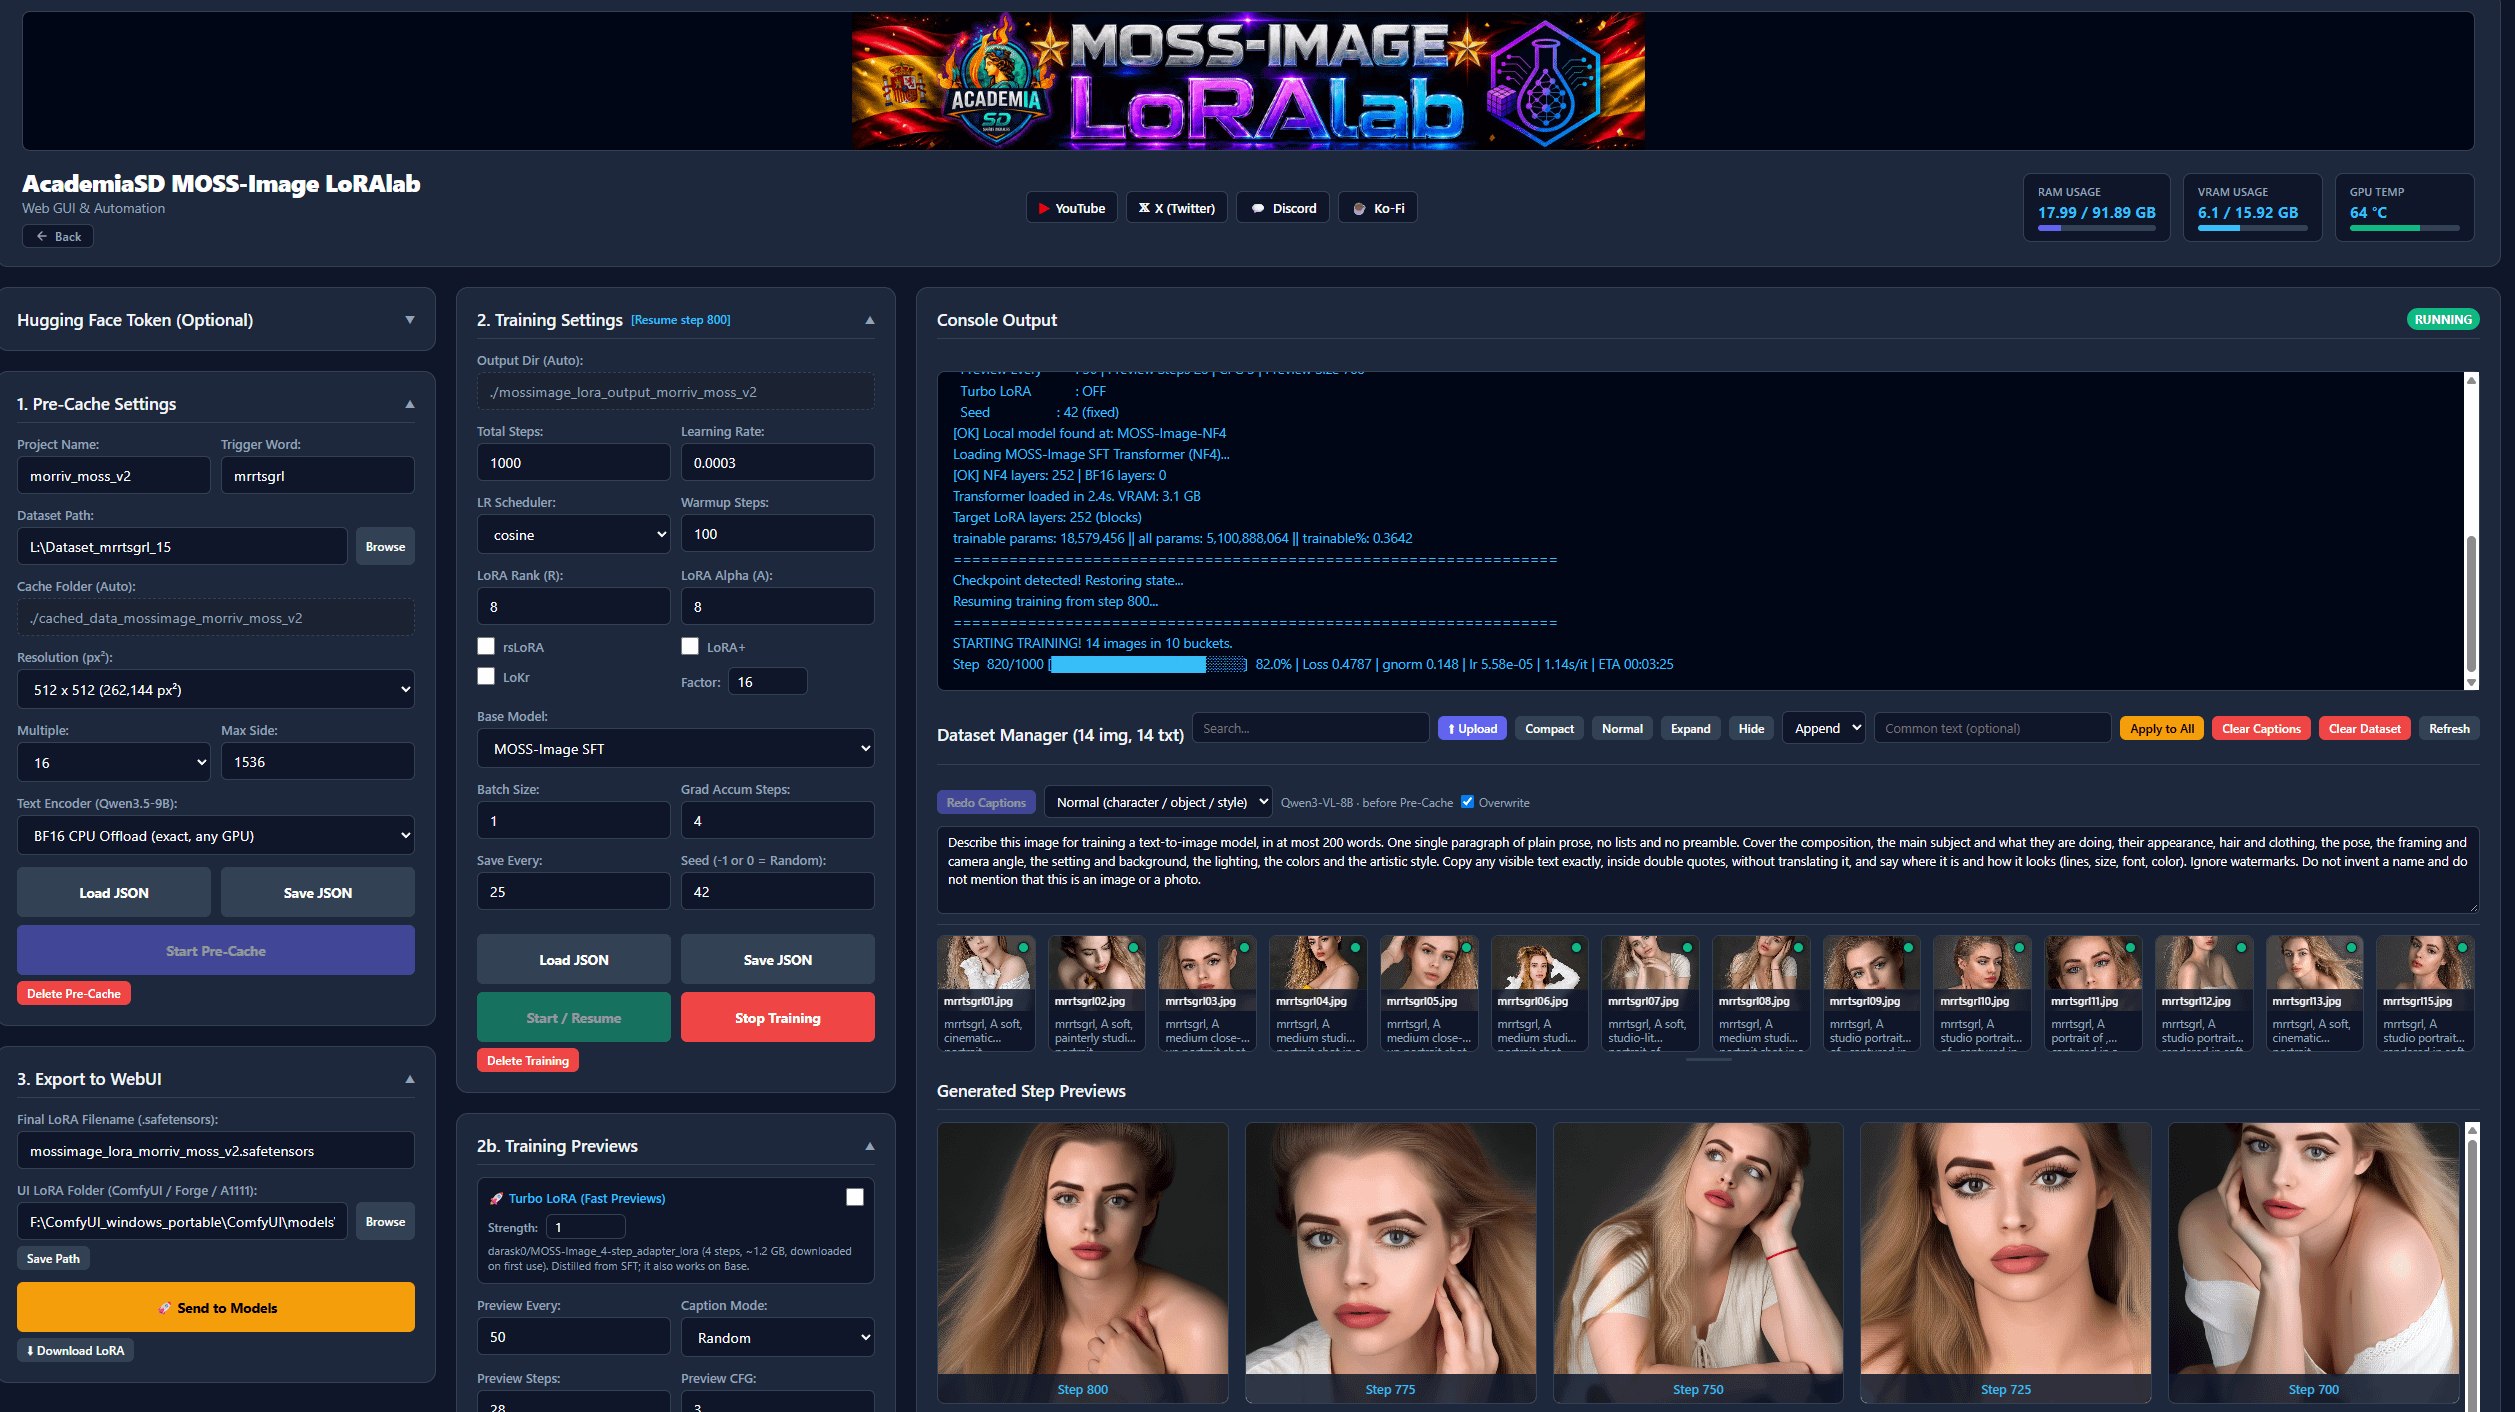
Вокруг модели появились официальные веса для ComfyUI, 4-шаговые и 8-шаговые варианты, LoRA против вертикальных полос и инструменты для JSON-промптов и layout. Для обучения AcademiaSD LoRAlab Trainer Studio поддерживает Base и SFT: заявлено около 1 с на шаг на RTX 5080 при расходе менее 6 ГБ VRAM; загрузка модели занимает от 9,9 до 20,2 ГБ в зависимости от text encoder. В Fizgig 8.6 обновили обучение LoRA на блоке 22 и быстрый пресет 0,25 MP с rank 16; в 8.7 настройку Clean-end share по умолчанию выставили на 60%.
A workflow combines krea2 turbo and MooshieUI to generate anime characters against realistic backgrounds, with recommended steps, CFG, sampler, resolution, and a sample prompt. A separate Krea 2 prompting guide covers ComfyUI setup, photorealism, poses, and architectural styles.
An Asian-character LoRA uses Krea 2 (raw) as its base and was trained with AdamW8Bit at a 0.0001 learning rate for 2500 steps on a hand-picked dataset that includes gravure idols and Japanese actresses.
A cinematic music-video teaser workflow uses Krea 2 character sheets for visual consistency, combines references to compose shots, and animates scenes with image-to-video and frame control. Its assets and tutorial PDF are available in Google Drive.
Moss Serenity is a MOSS Base fine-tune with an initial 24000 steps focused on image quality. Base and int8 variants and extracted LoRAs are available. A trainer for further fine-tuning is planned, and the creator invites community work on merges and improvements.
OpenSpline provides an open-source workflow for generating lipsynced video from an image and a selected voice. Its creator reports real-time local performance of over 90 FPS on an RTX 4090.
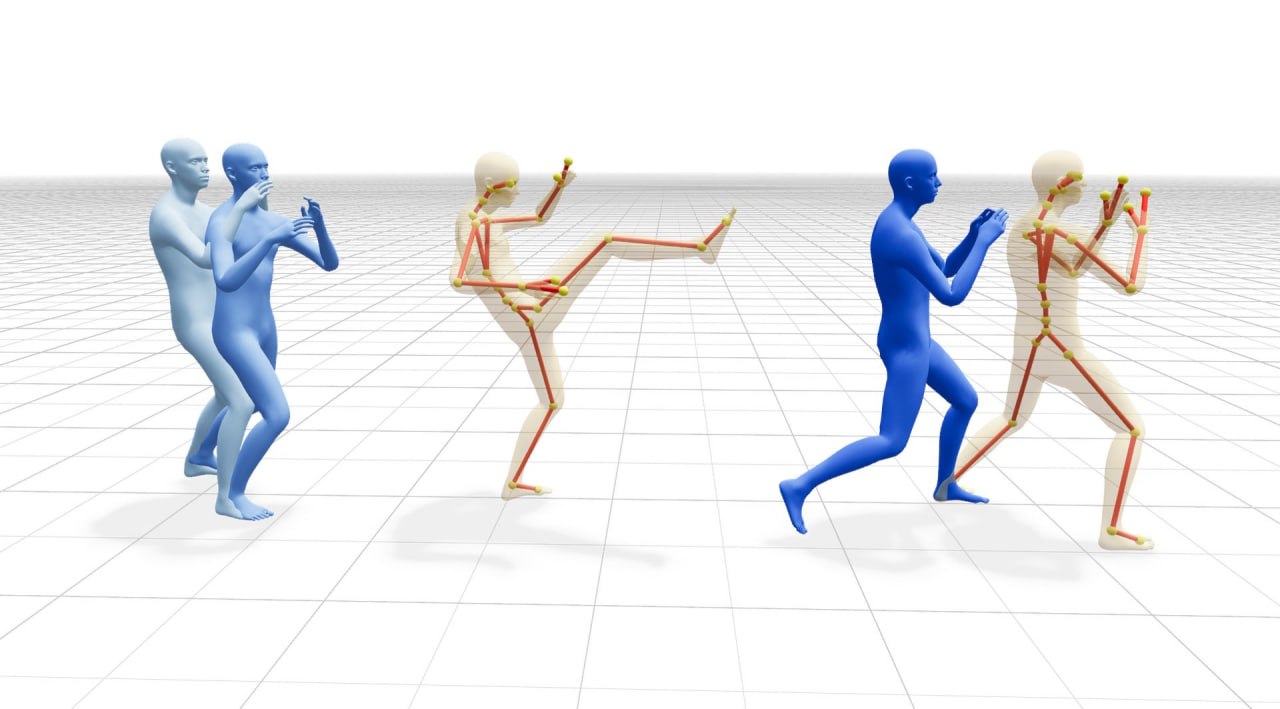
NVIDIA выпустила Kimodo-SOMA-RP-v1.2 со сглаженным корневым движением и исправленными разбиениями данных. Kimodo-SOMA-RP-ArdyRep-v1.2 использует ту же базу, но сохраняет сырую траекторию бедра для совместимости с ARDY. ARDY-SOMA-RP-KimodoRep — авторегрессивная ARDY в представлении Kimodo.
В апрельской Kimodo v1.1 часть тестовых последовательностей попала в обучение, поэтому метрики были несопоставимы. В v1.2 утечку убрали, а скольжение стоп уменьшили. ARDY вышла в июле; теперь у неё есть вариант в представлении Kimodo. Kimodo генерирует клип фиксированной длины за один проход: 282M параметров, до 10 с при 30 fps. ARDY работает авторегрессивно и в реальном времени: 192M параметров, история и выход — до 8 с.
Проект Stanford и NVIDIA для NeurIPS 2026 восстанавливает 4D-сцену на гауссианах из одного видео. За основу взята реконструкция MoSca: видеомодель DiffSynth создаёт виды с новых камер, после чего полученные кадры дистиллируются обратно в сцену. Для восполнения недостающих данных используется видеомодель на базе Wan2.1-VACE-14B.
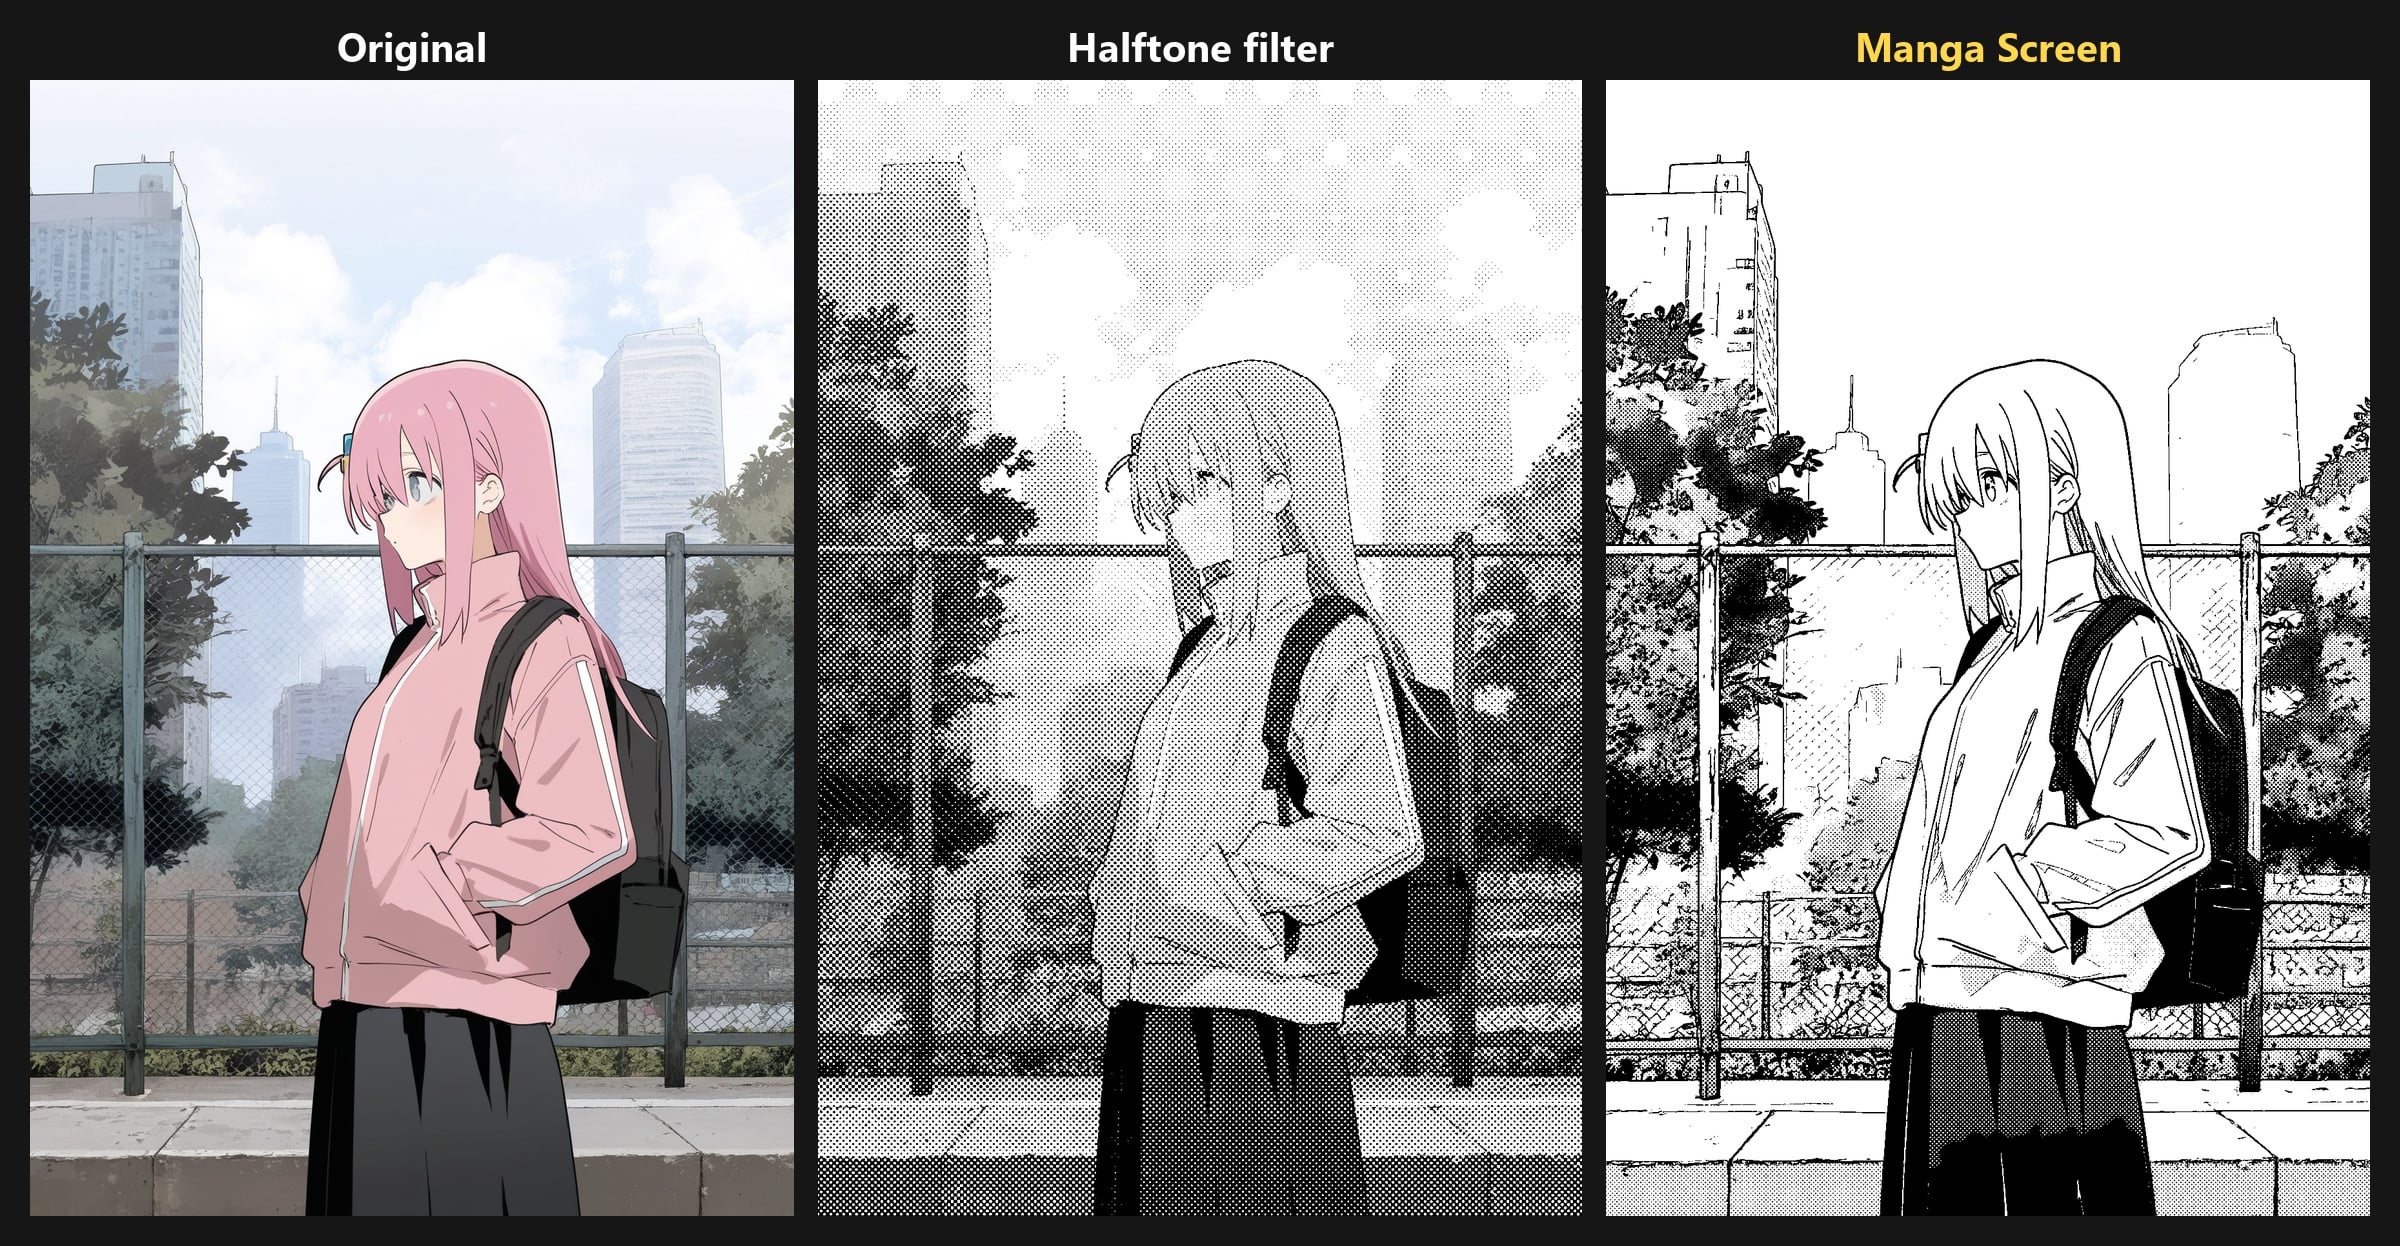
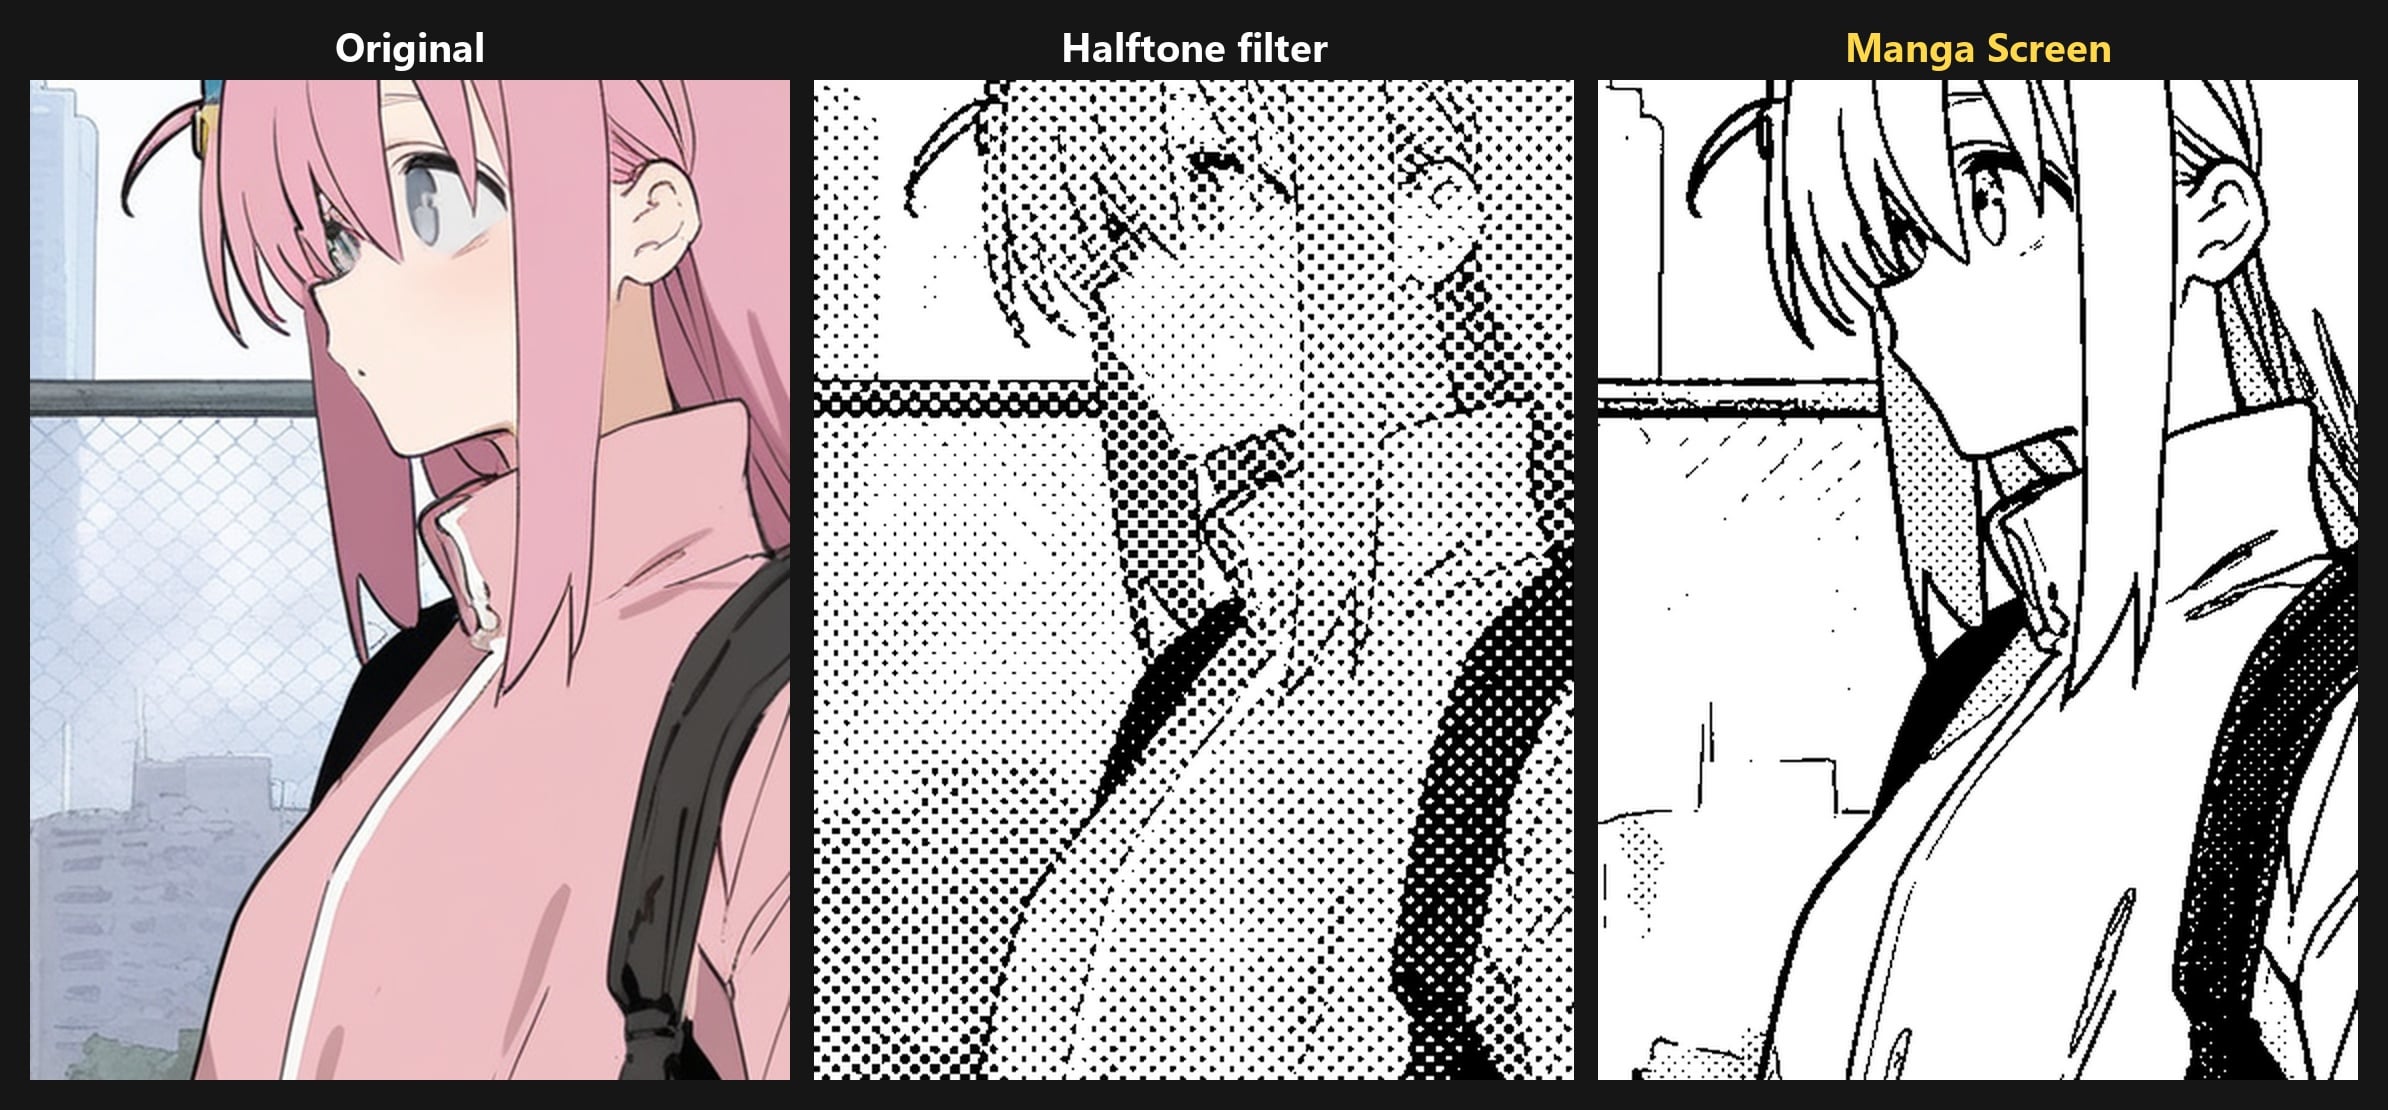
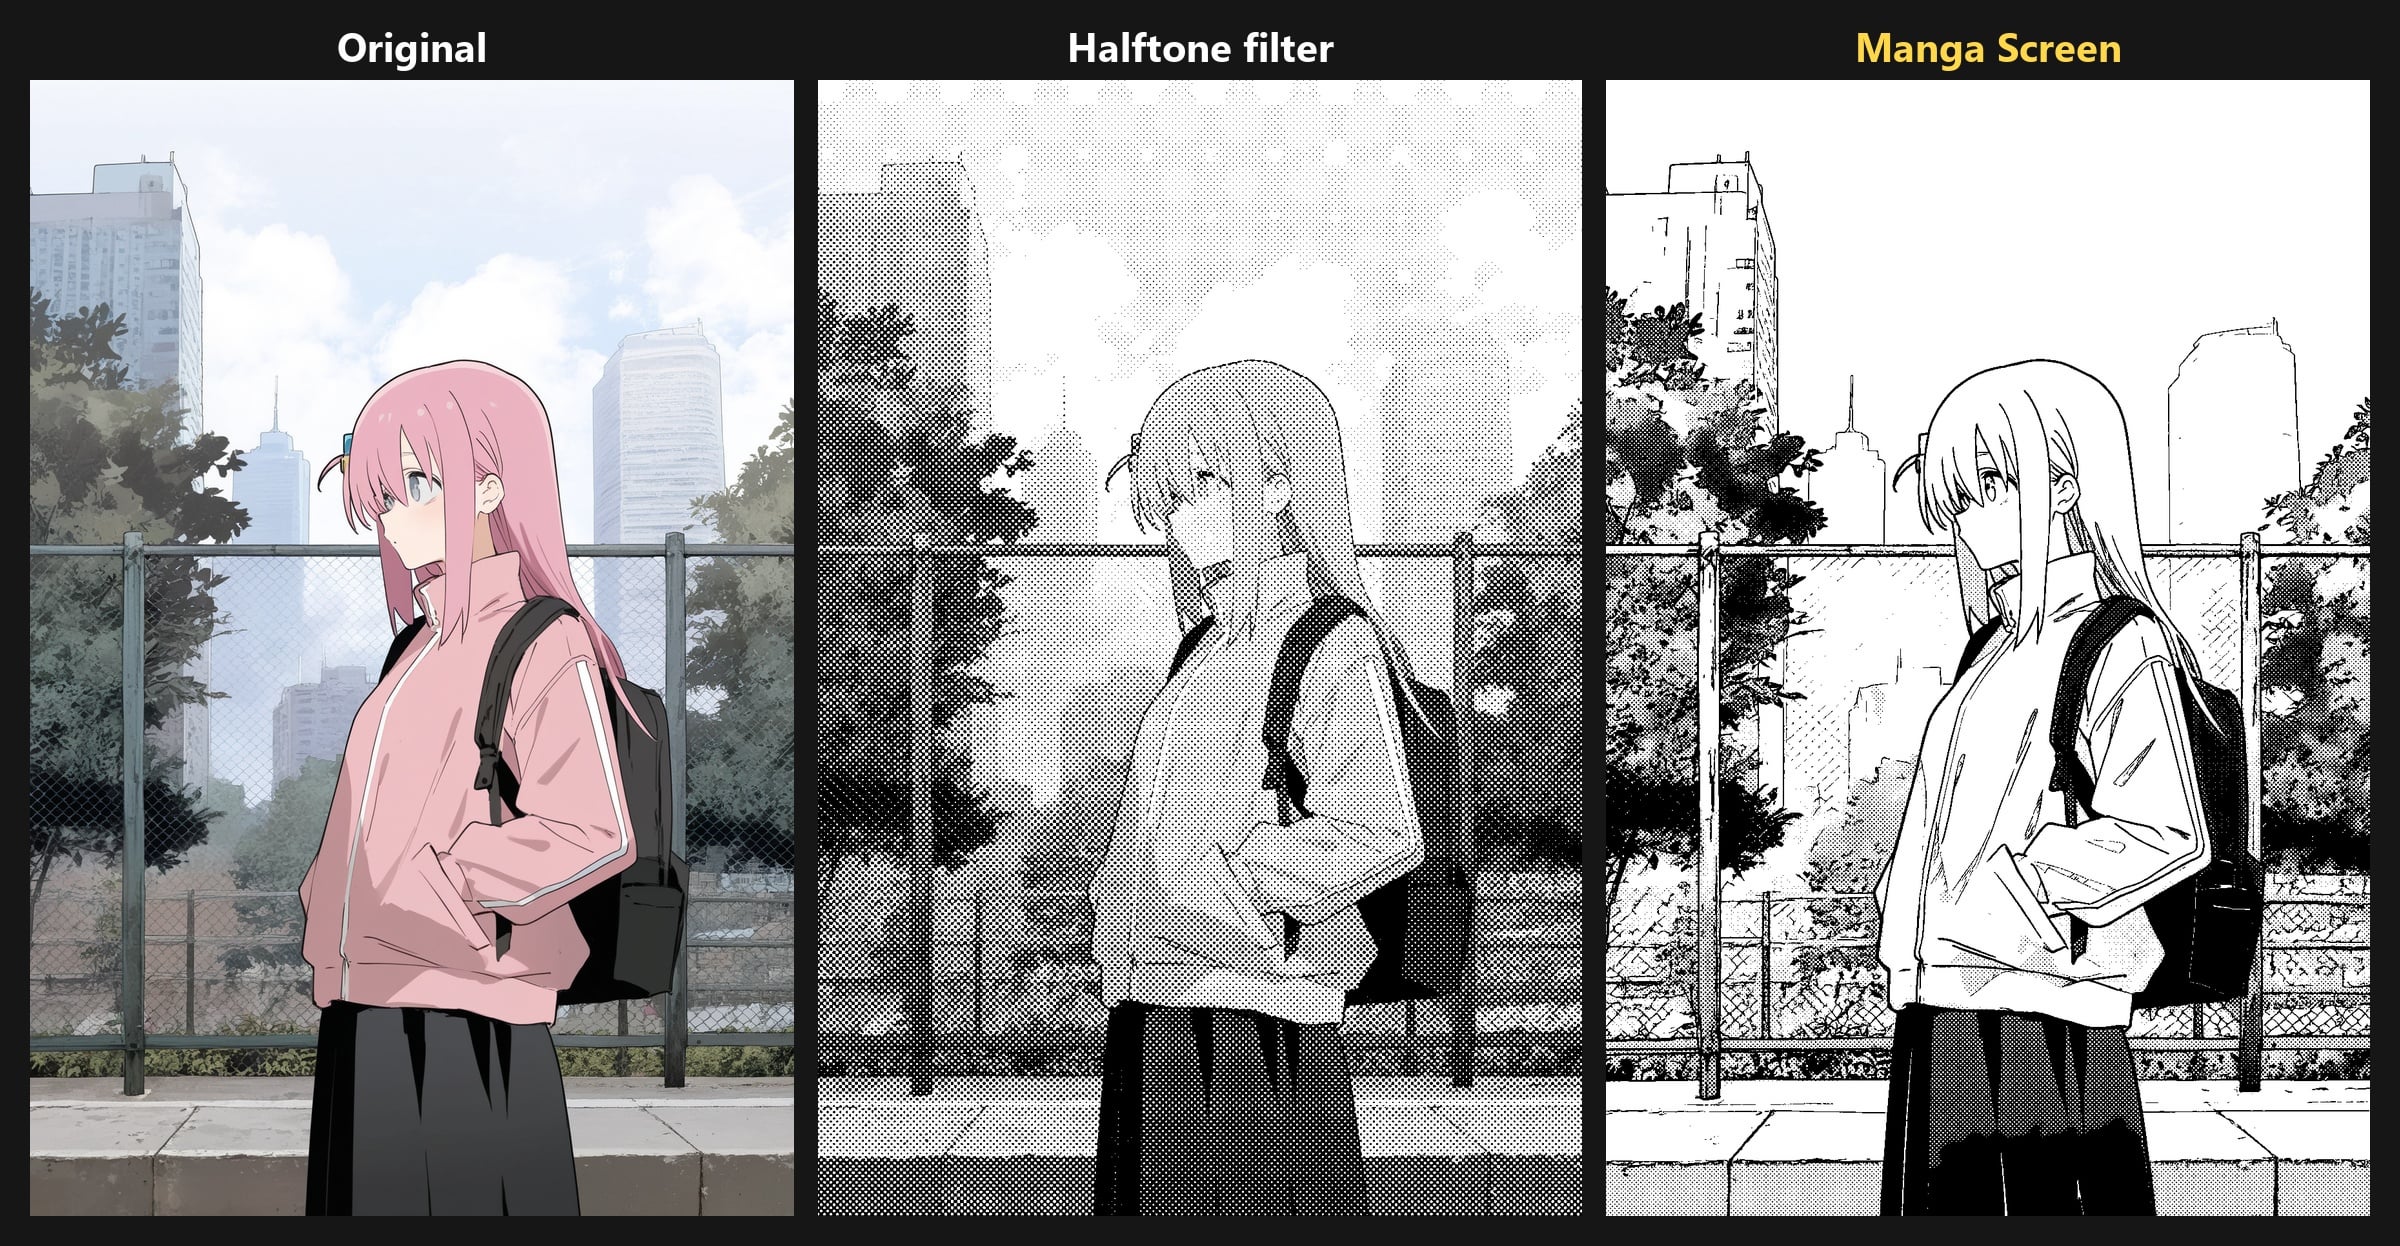
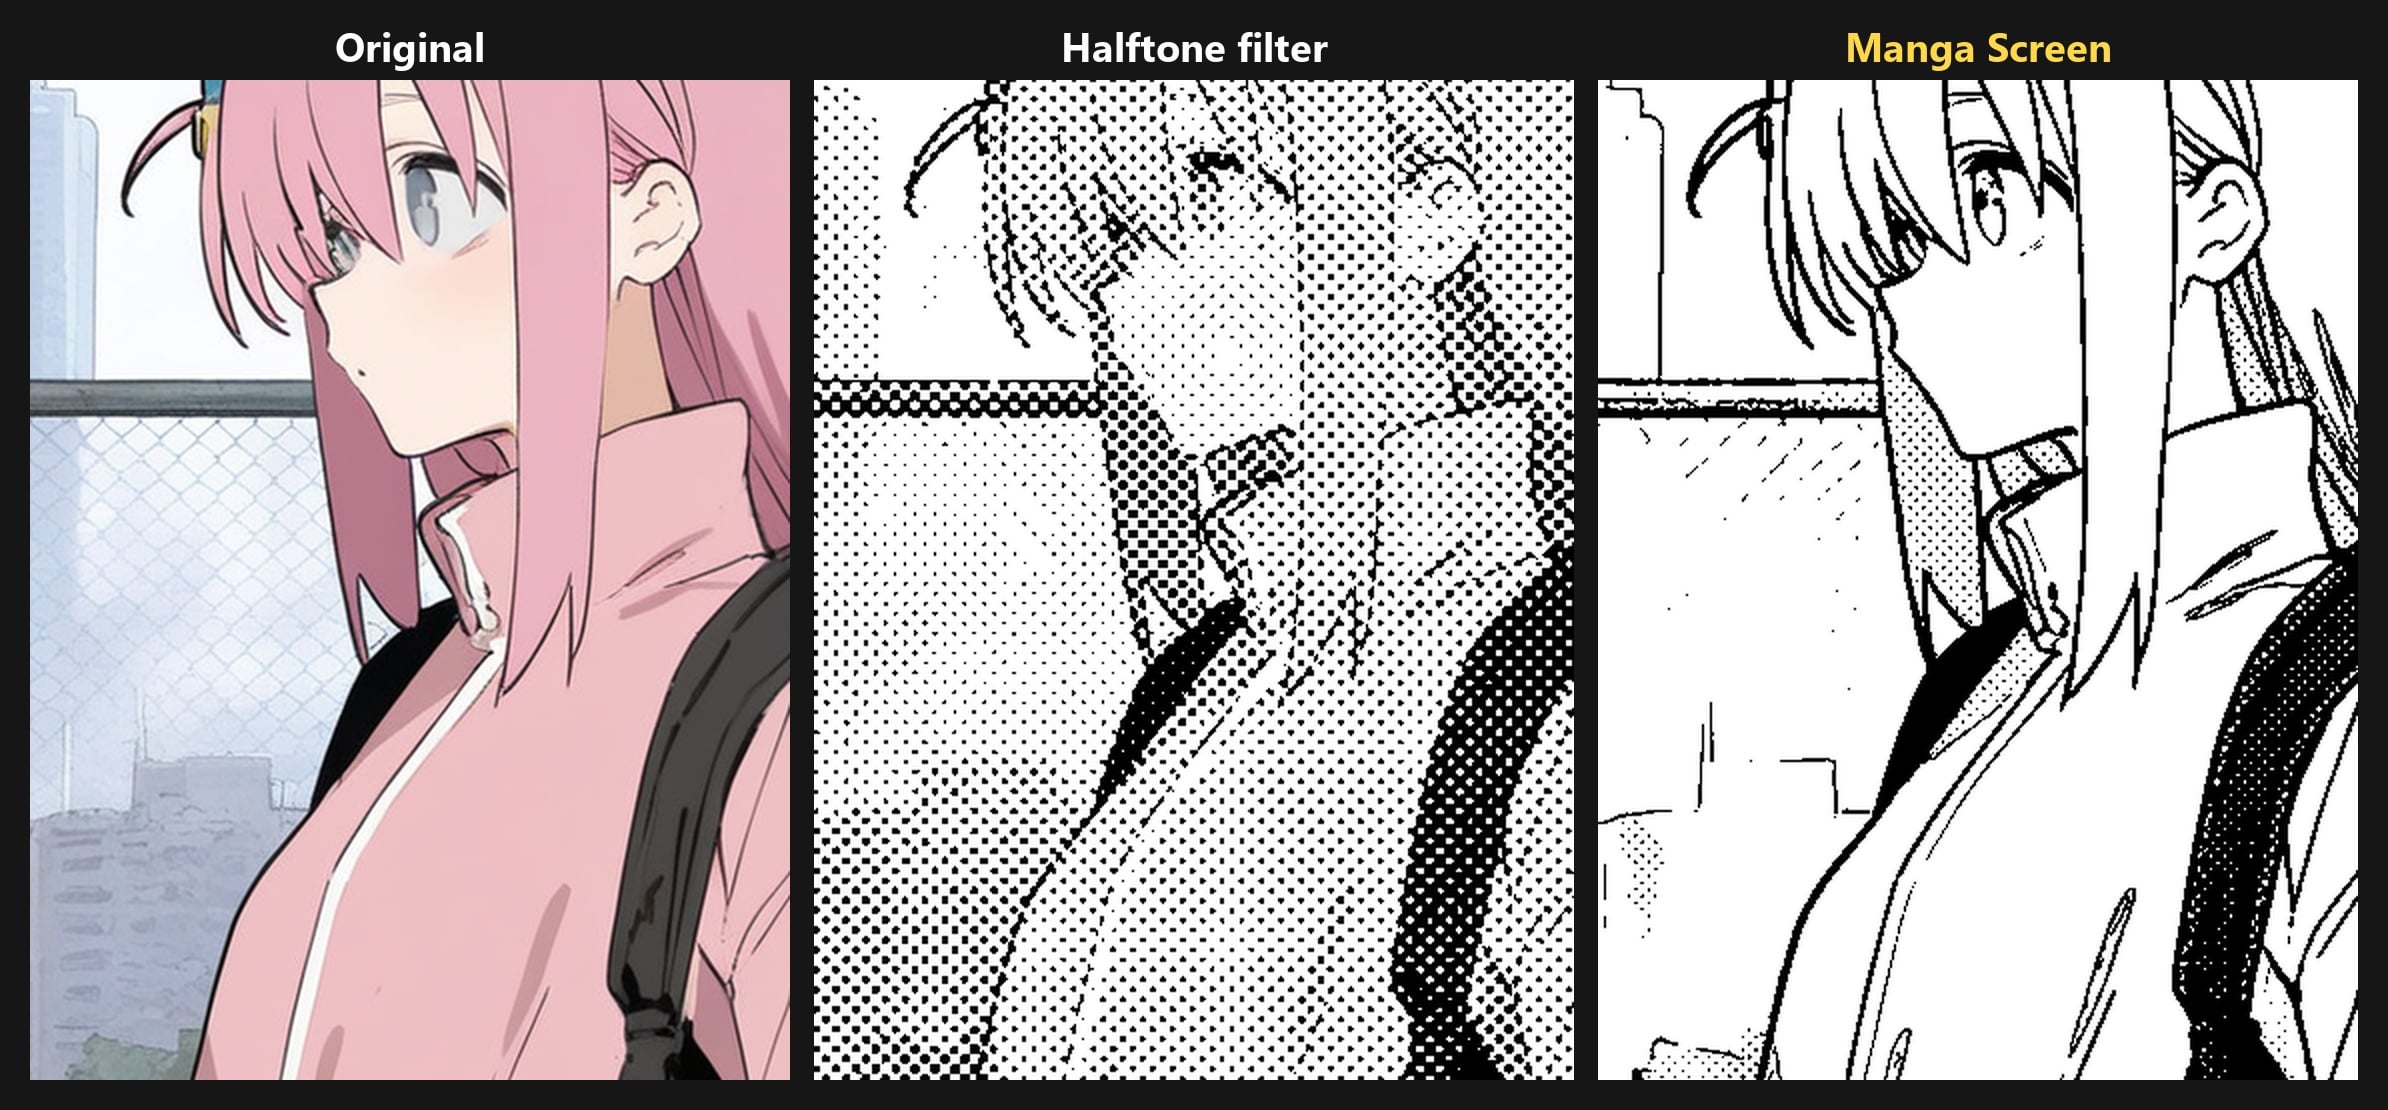
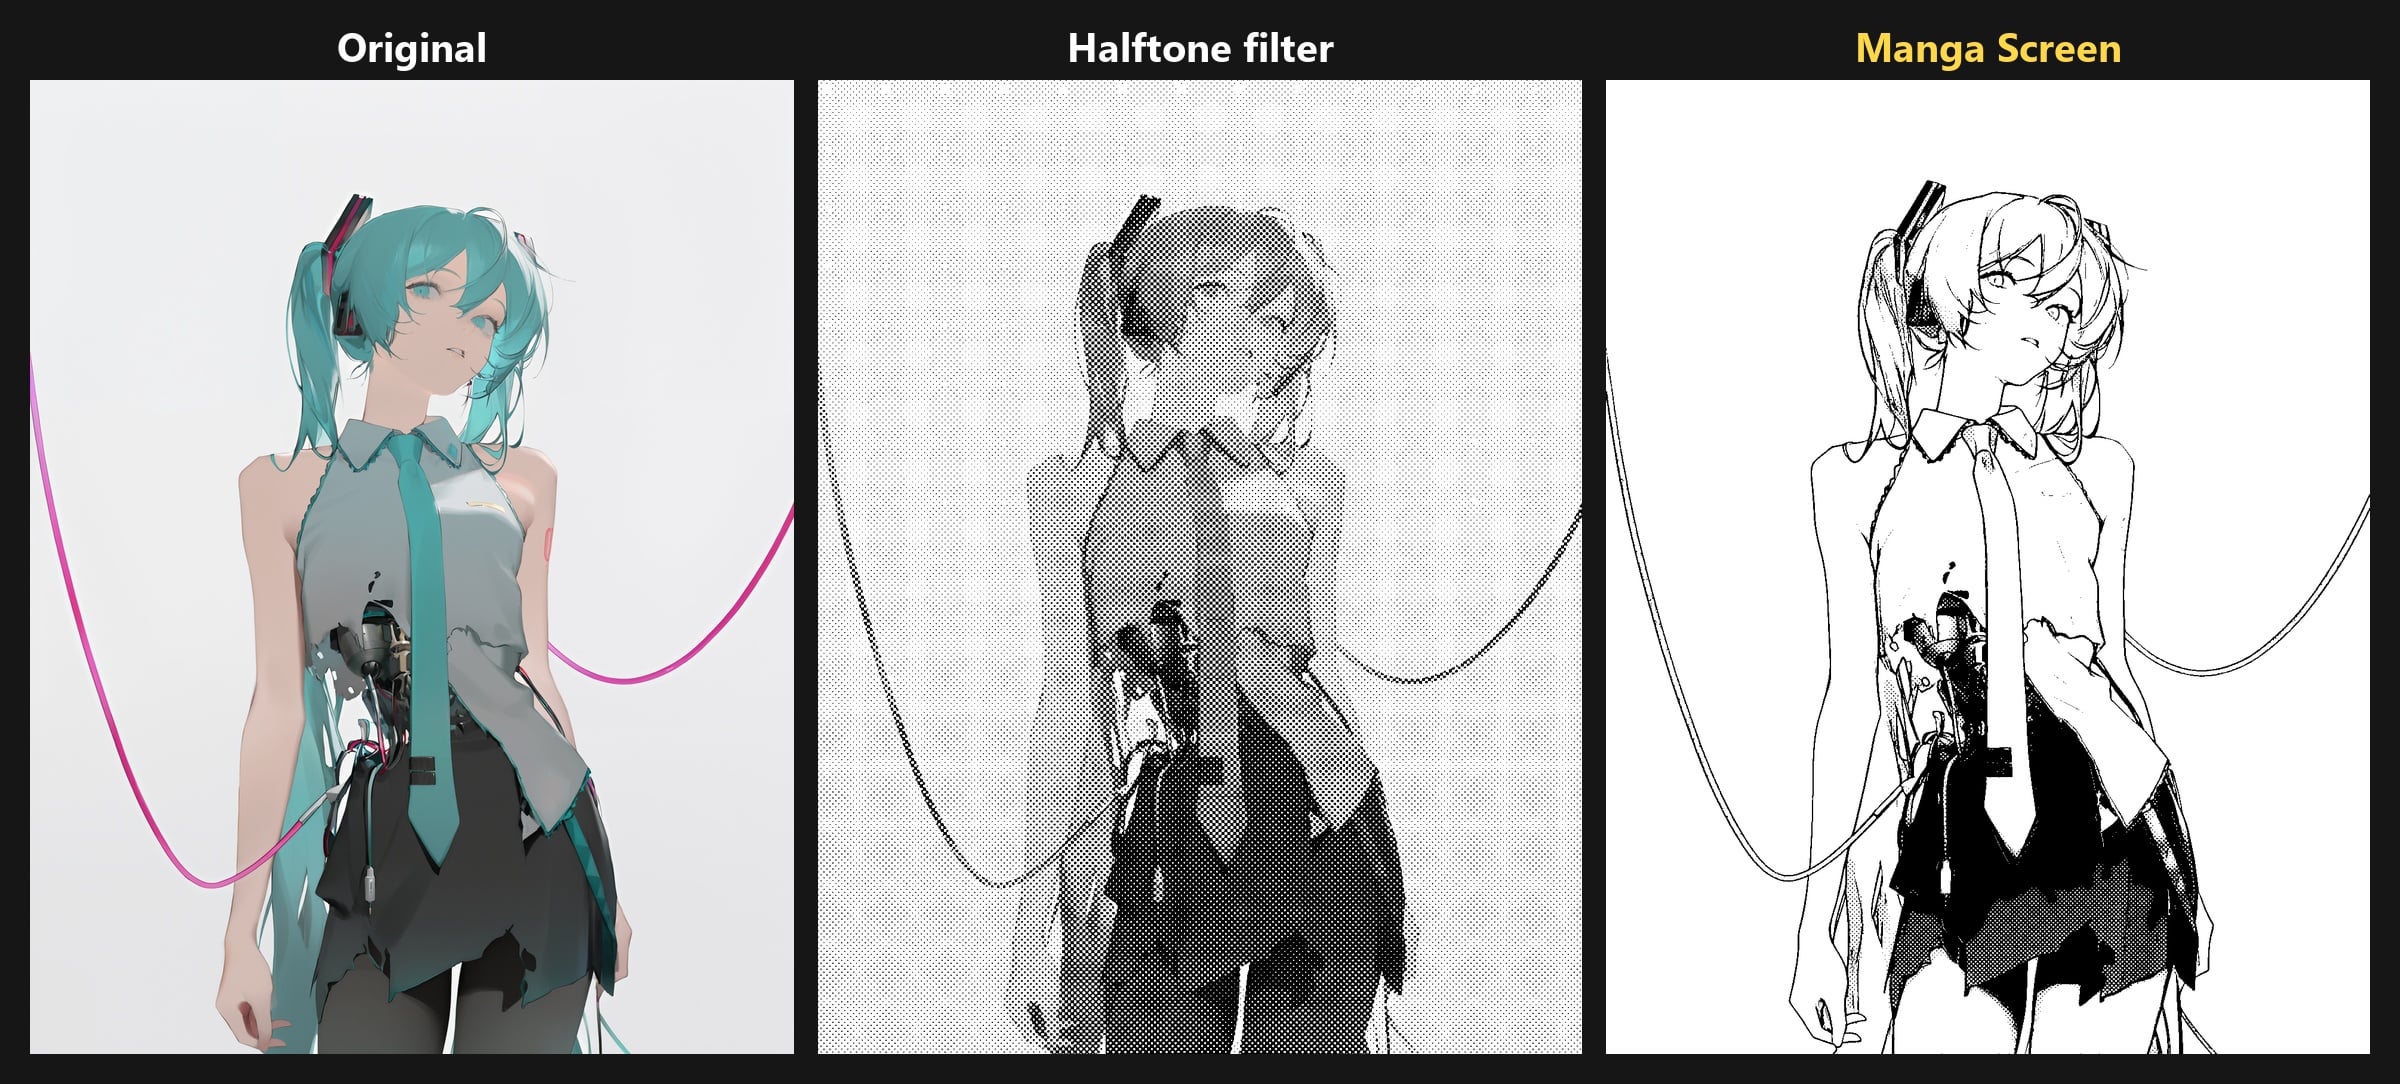
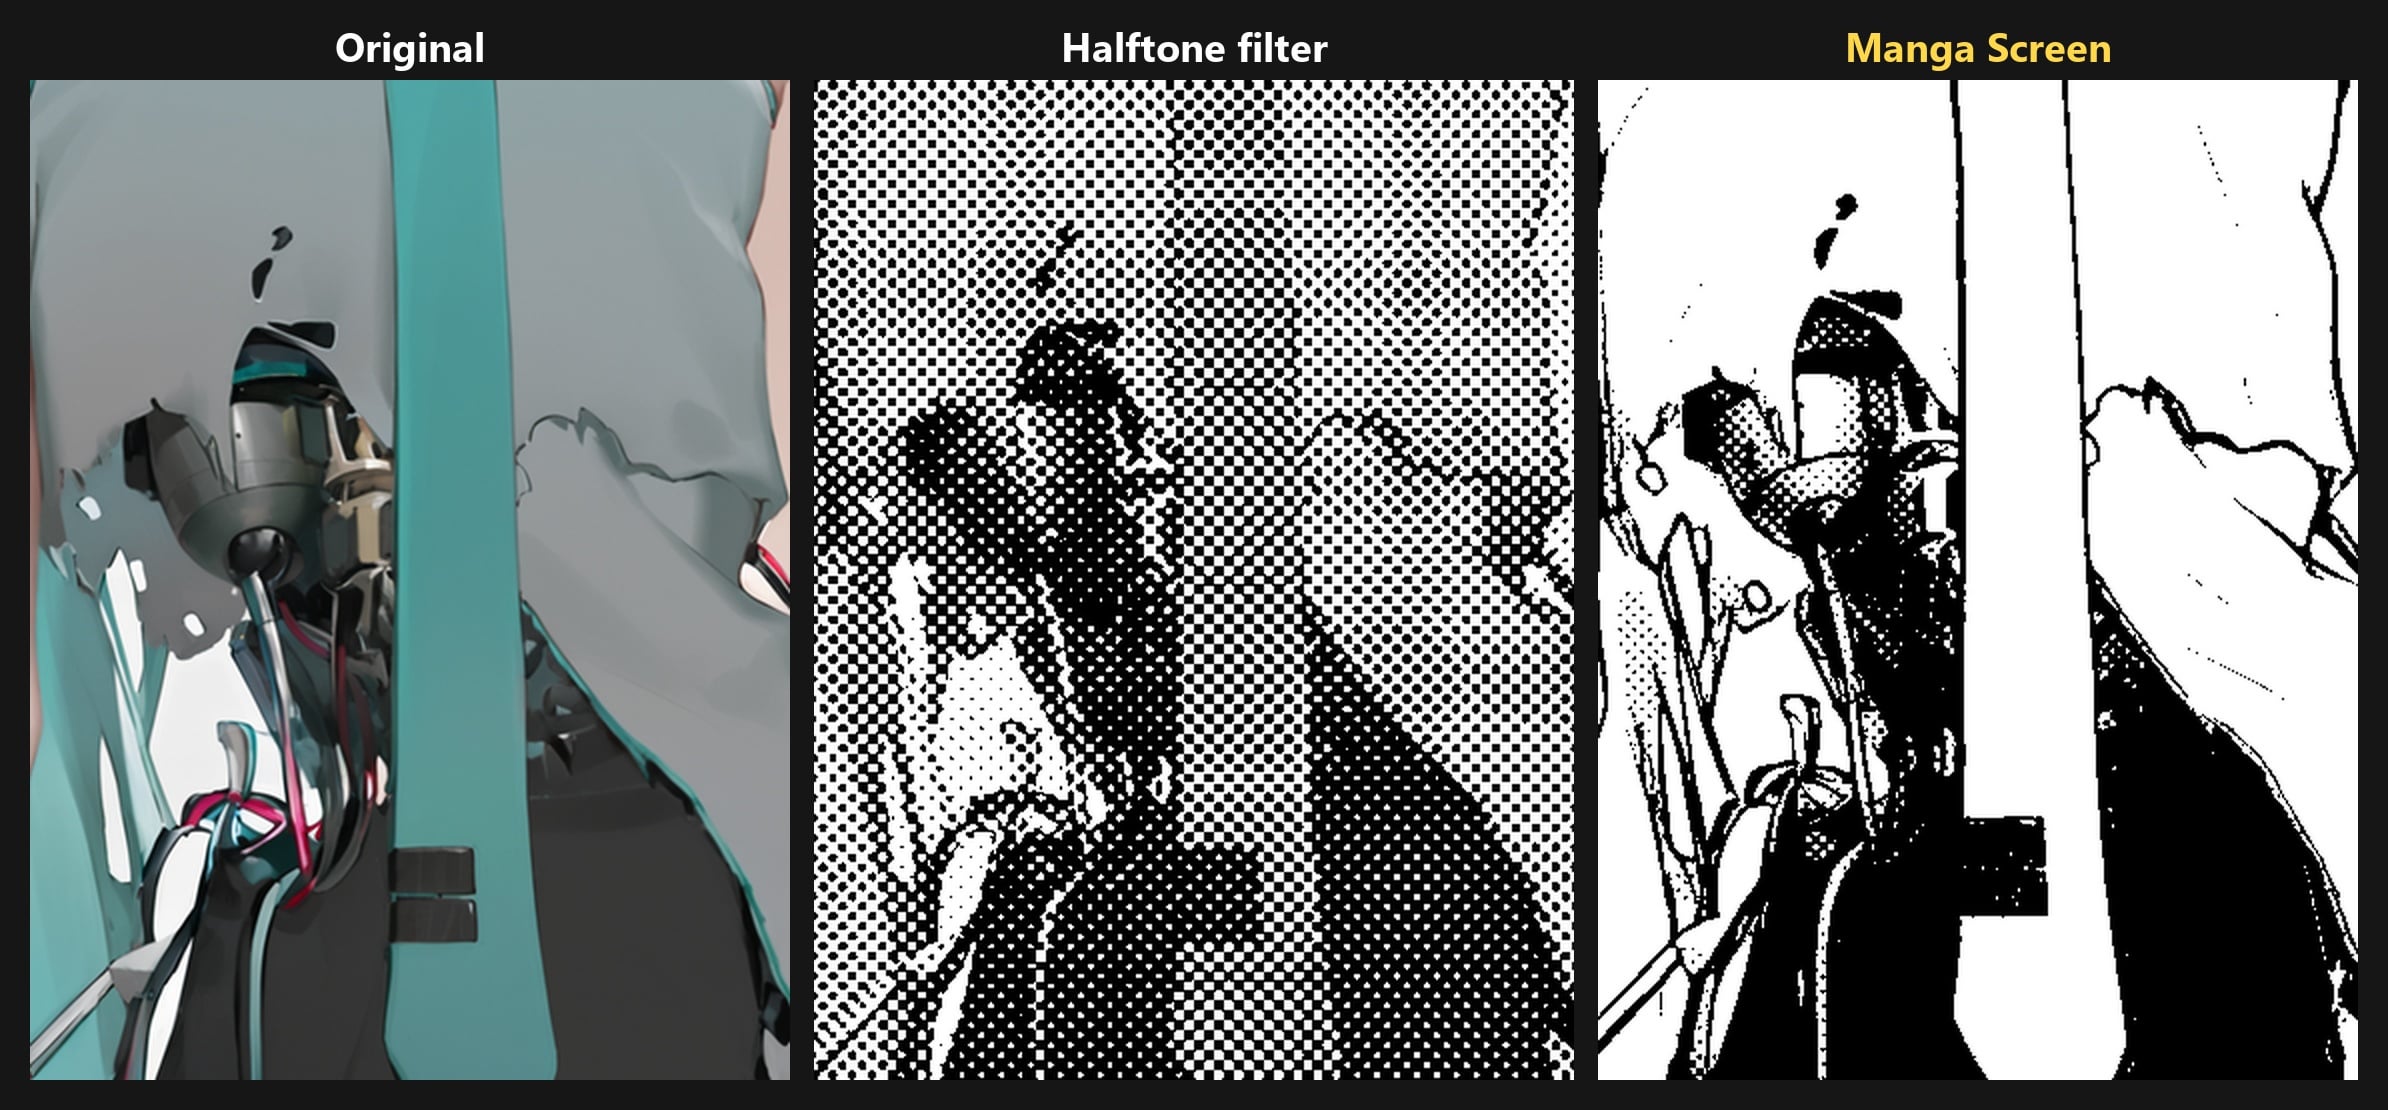
ComfyUI-MangaScreen uses Qwen-Image 2.1 Turbo to redraw colors as black, white, and toned areas. Its nodes handle manga finishing, line extraction, and panel borders; a Manga-Lite workflow creates clean line art without the edit model.
The MIT-licensed pack is distributed as a single Python file, requires numpy, opencv, and torch, and can be installed through ComfyUI Manager by searching for “Manga Screen.”
OpenFill is a free, beta GIMP 3 plugin that connects to ComfyUI and local image models. It offers prompt-based generative fill with up to 8 variations, prompt-free object removal using LaMa or MAT, outpainting on any side or to a chosen aspect ratio, and text-to-image generation on a new layer or as a separate image.
It ships with defaults including DreamShaper 8 Inpainting and RealVisXL V5. It supports Windows, Linux, and Mac; NVIDIA hardware is recommended. Processing stays on the local machine.
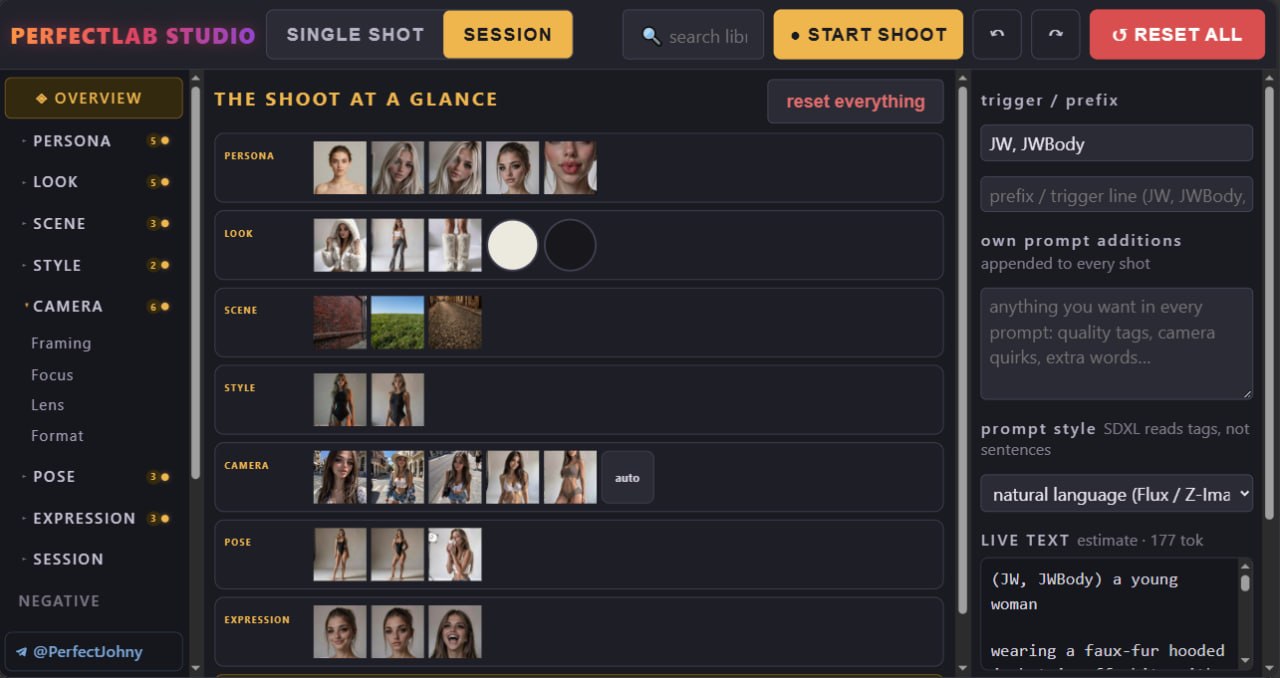
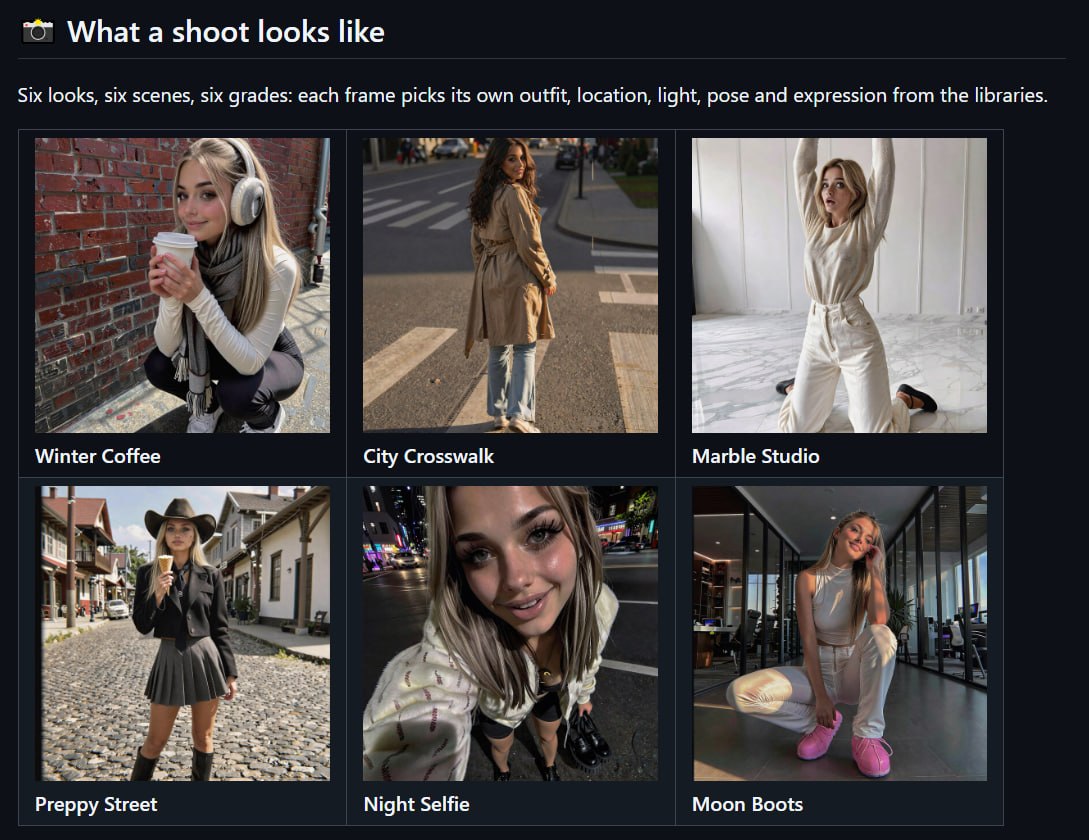
PerfectLab Studio собирает серии кадров в ComfyUI. Пользователь выбирает человека, одежду, место, свет и камеру из библиотек с фото-превью; node составляет промпты, размеры и сиды и отправляет всю сессию в граф.
Есть профили для Z-Image, Flux, Krea 2, Qwen-Image и SDXL. Для SDXL промпты автоматически переключаются на теги через запятую. Поддерживаются карточки персонажей, пресеты, свои вайлдкарды и арки. Для H3-анимации из готовой серии выбирают стартовый, средний и финальный кадры.
Clown Anchoring brings together a Clown Context workflow, H3 Clown Anchoring, ComfyUI-H3-Motion-Context-MultiRef, and nodes for loading batches of video, text, and audio from directories.
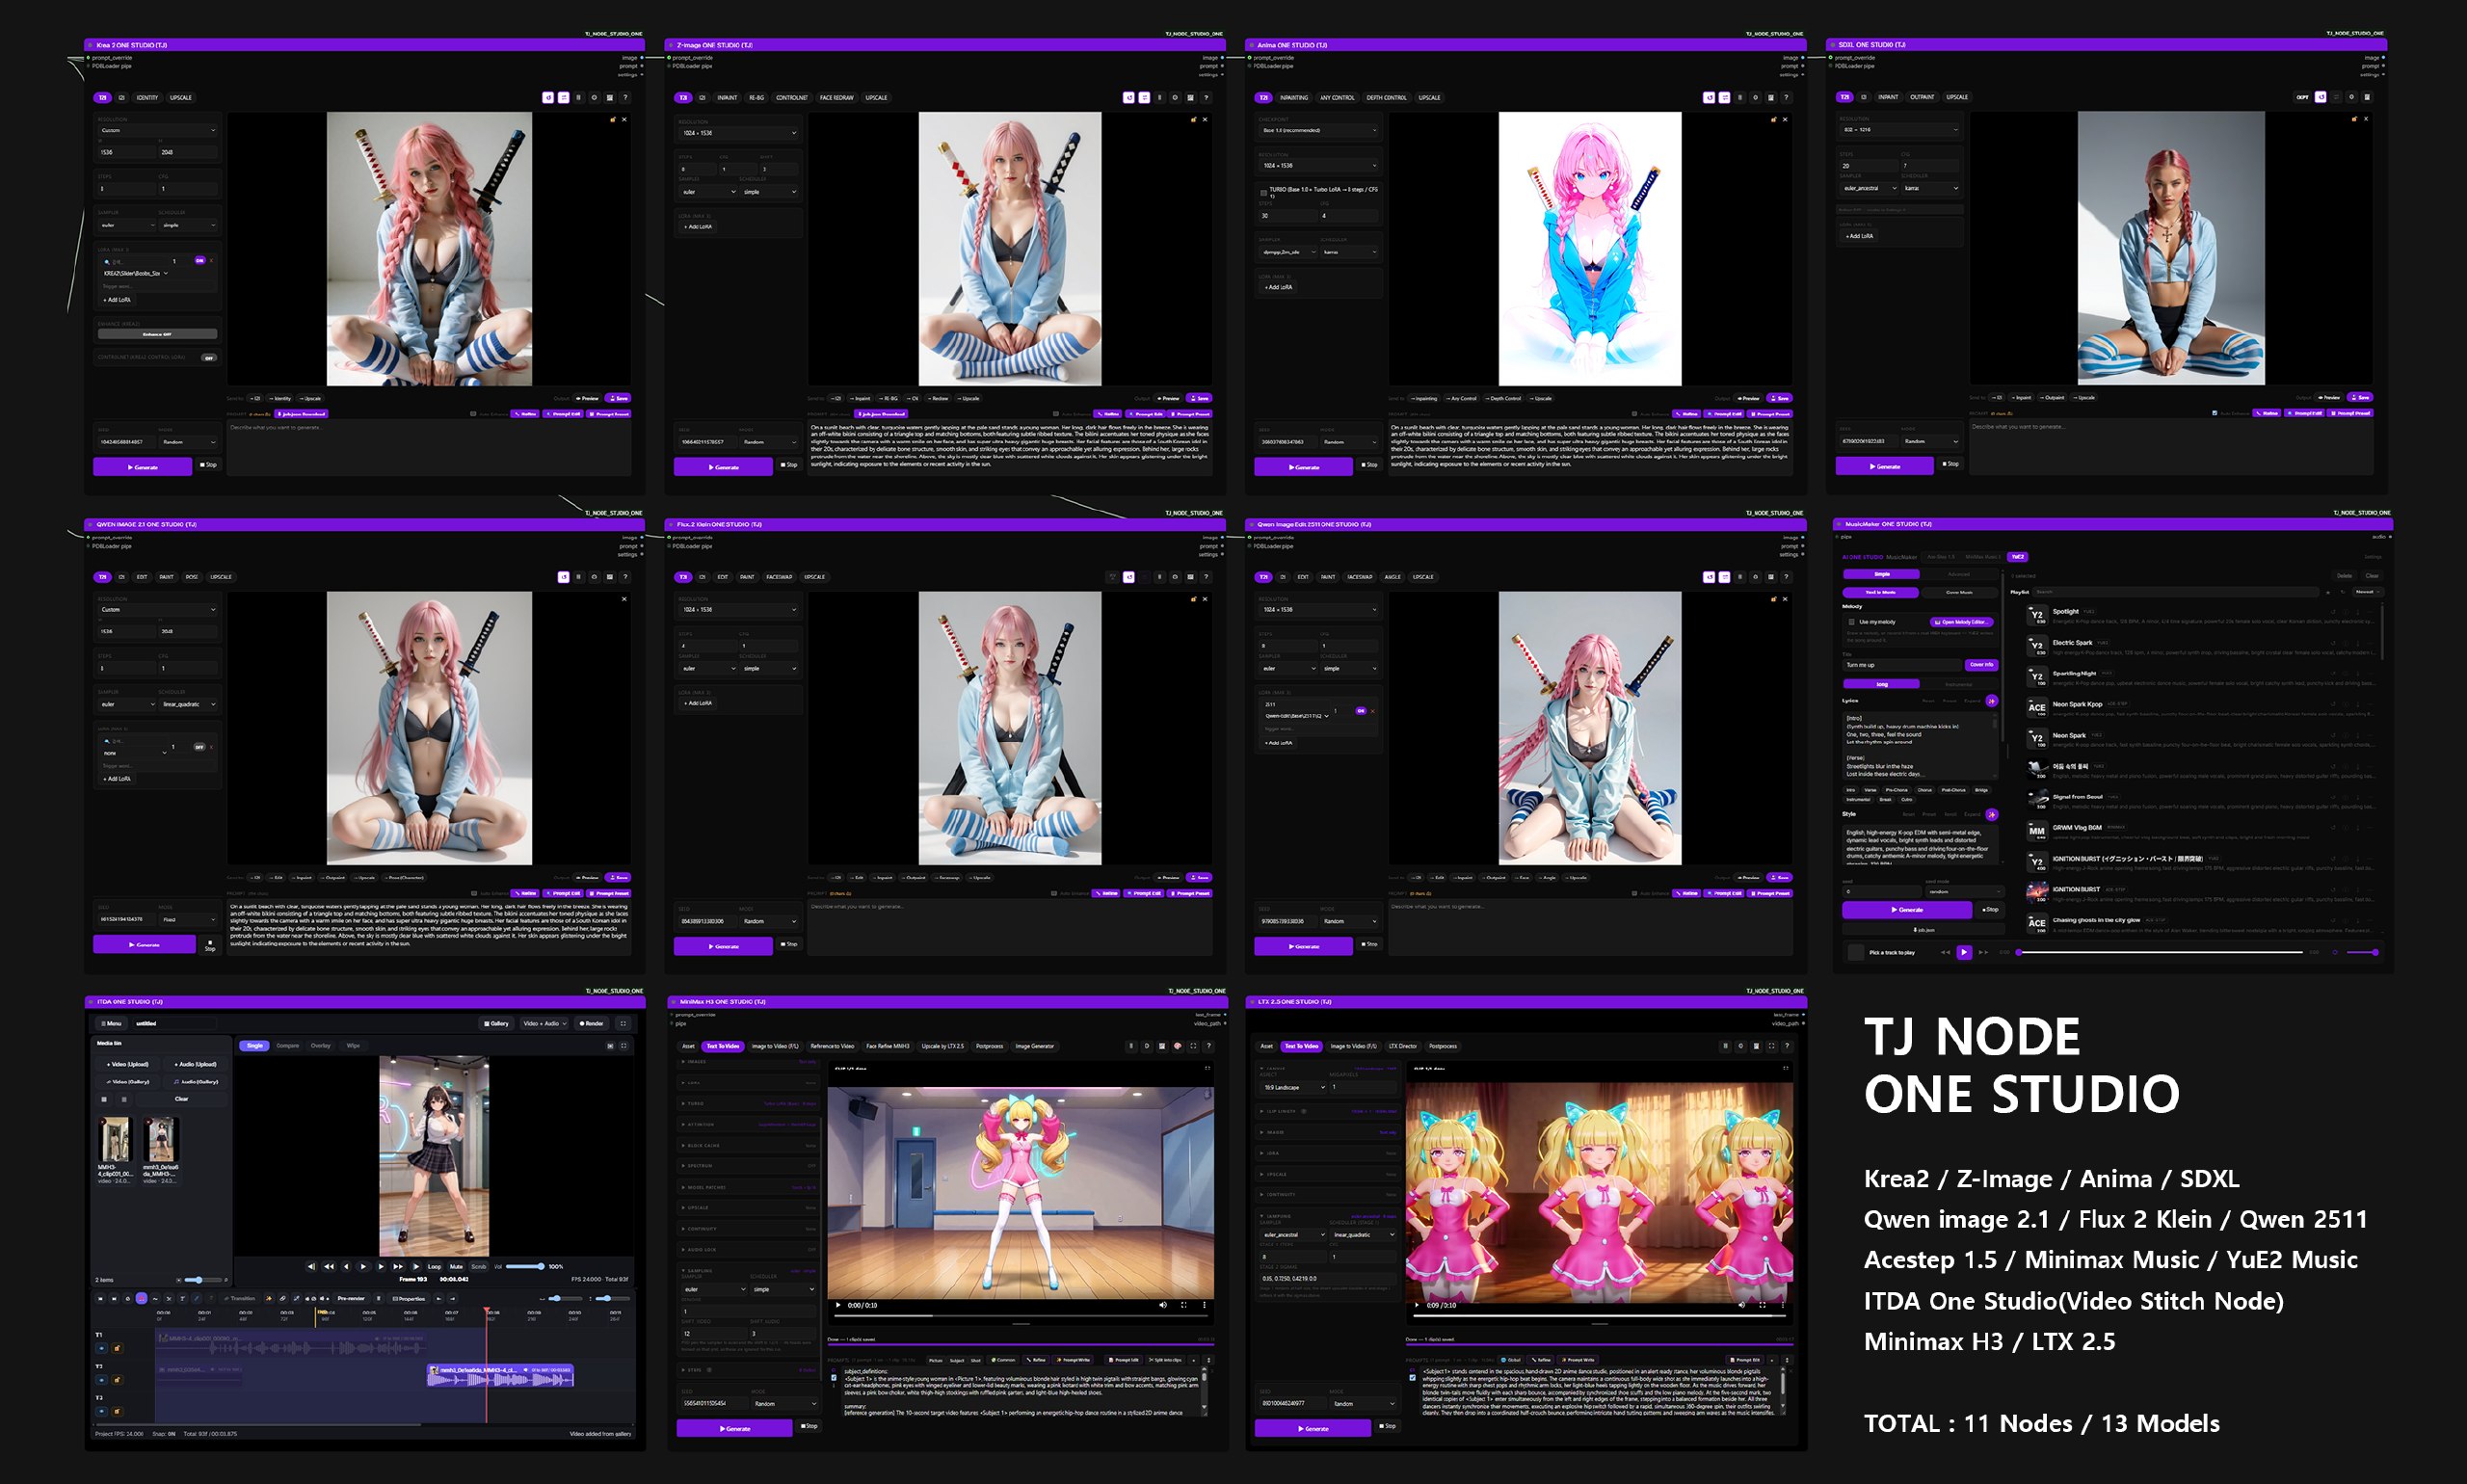
One Studio Set collects 11 custom ComfyUI nodes for generation, editing, upscaling, prompt writing, and a gallery. The install_requirements.bat script installs requirements automatically; a workflow JSON loads all the nodes at once. The related TJNODE pack adds more nodes, while the AI ONE STUDIO web version requires a ComfyUI server.
selflift-Fish is a version of the SelfLift node intended to generate longer, higher-resolution videos with less VRAM pressure. It fixes background swelling and shifting in the original version, keeps attention acceleration, and reduces total generation time.
ComfyUI v0.42.1 fixes crashes in the MOSS image template workflow and updates the Krea 3 Image Partner Node. It also includes MOSS-image support improvements.
NodeWatch tracks commits and activity across the top 300 ComfyUI custom node packs over the last 12+ months. It also offers a weekly email digest of pack status, recent issues, and updates.
ComfyUI v0.41.3 updates the FLUX 3 Image Klein workflows with optimized settings and a reintroduced prompt upsampler for improved image quality. The updates cover Text to Image and Image Edit steps, with clearer model-file names.
The process aims to isolate trained identities so their features do not blend across subjects in an image. It uses Differential Output Preservation (DOP) from Ostris’s AI-Toolkit, fused-token class decoupling to train identities as linked tokens such as “gweltman,” and in-frame negative-pair compositing to improve reliability across subject types. Documentation, release notes, a demo, and a setup video are available.
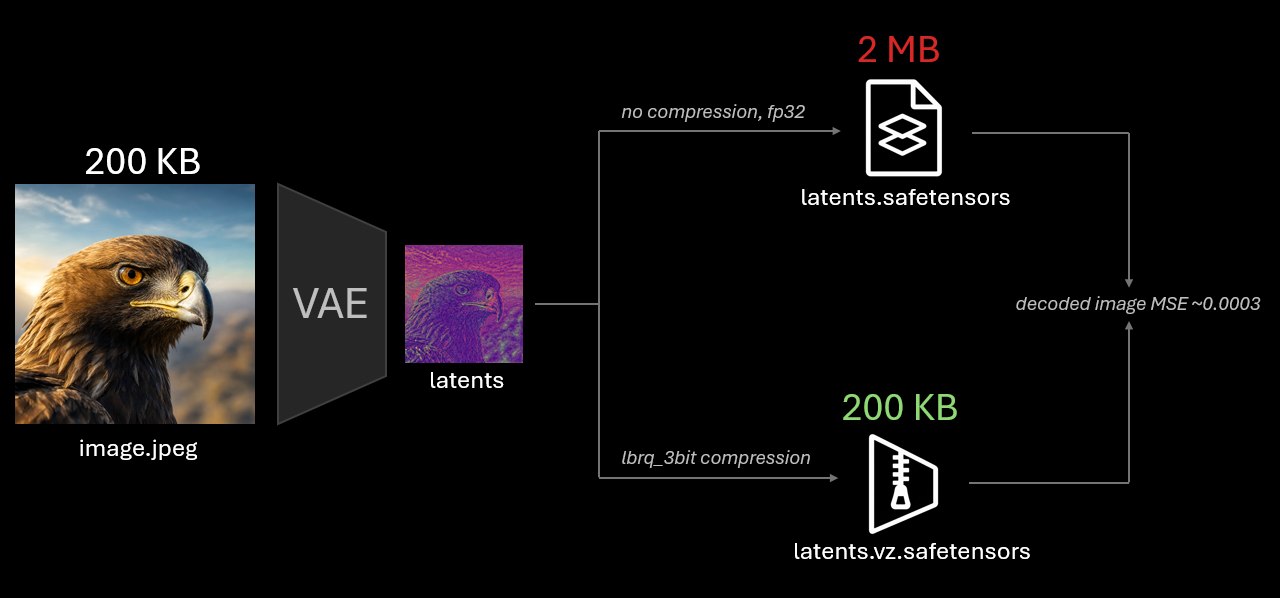
VaeZip is a PyTorch library of latent quantization codecs designed to reduce storage while maintaining reconstruction fidelity. Companion benchmarks compare reconstruction quality and storage efficiency across algorithms, and measure how codec compression affects training performance.
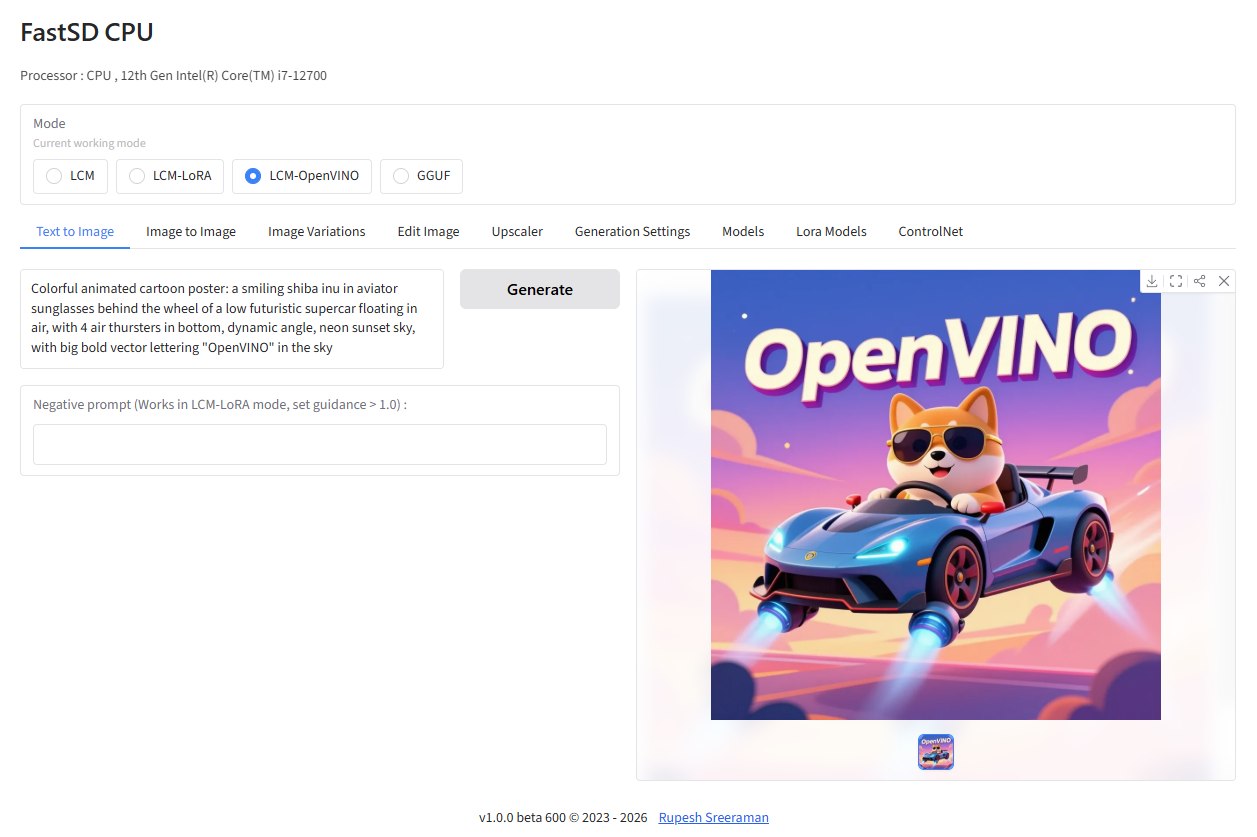
The latest FastSDCPU release introduces an image model that works directly in pixel space, without a VAE or latent space. Optimized for Intel CPUs with OpenVINO, it generates a 1024×1024 image in approximately 80 seconds using 4 steps and INT8 weights.
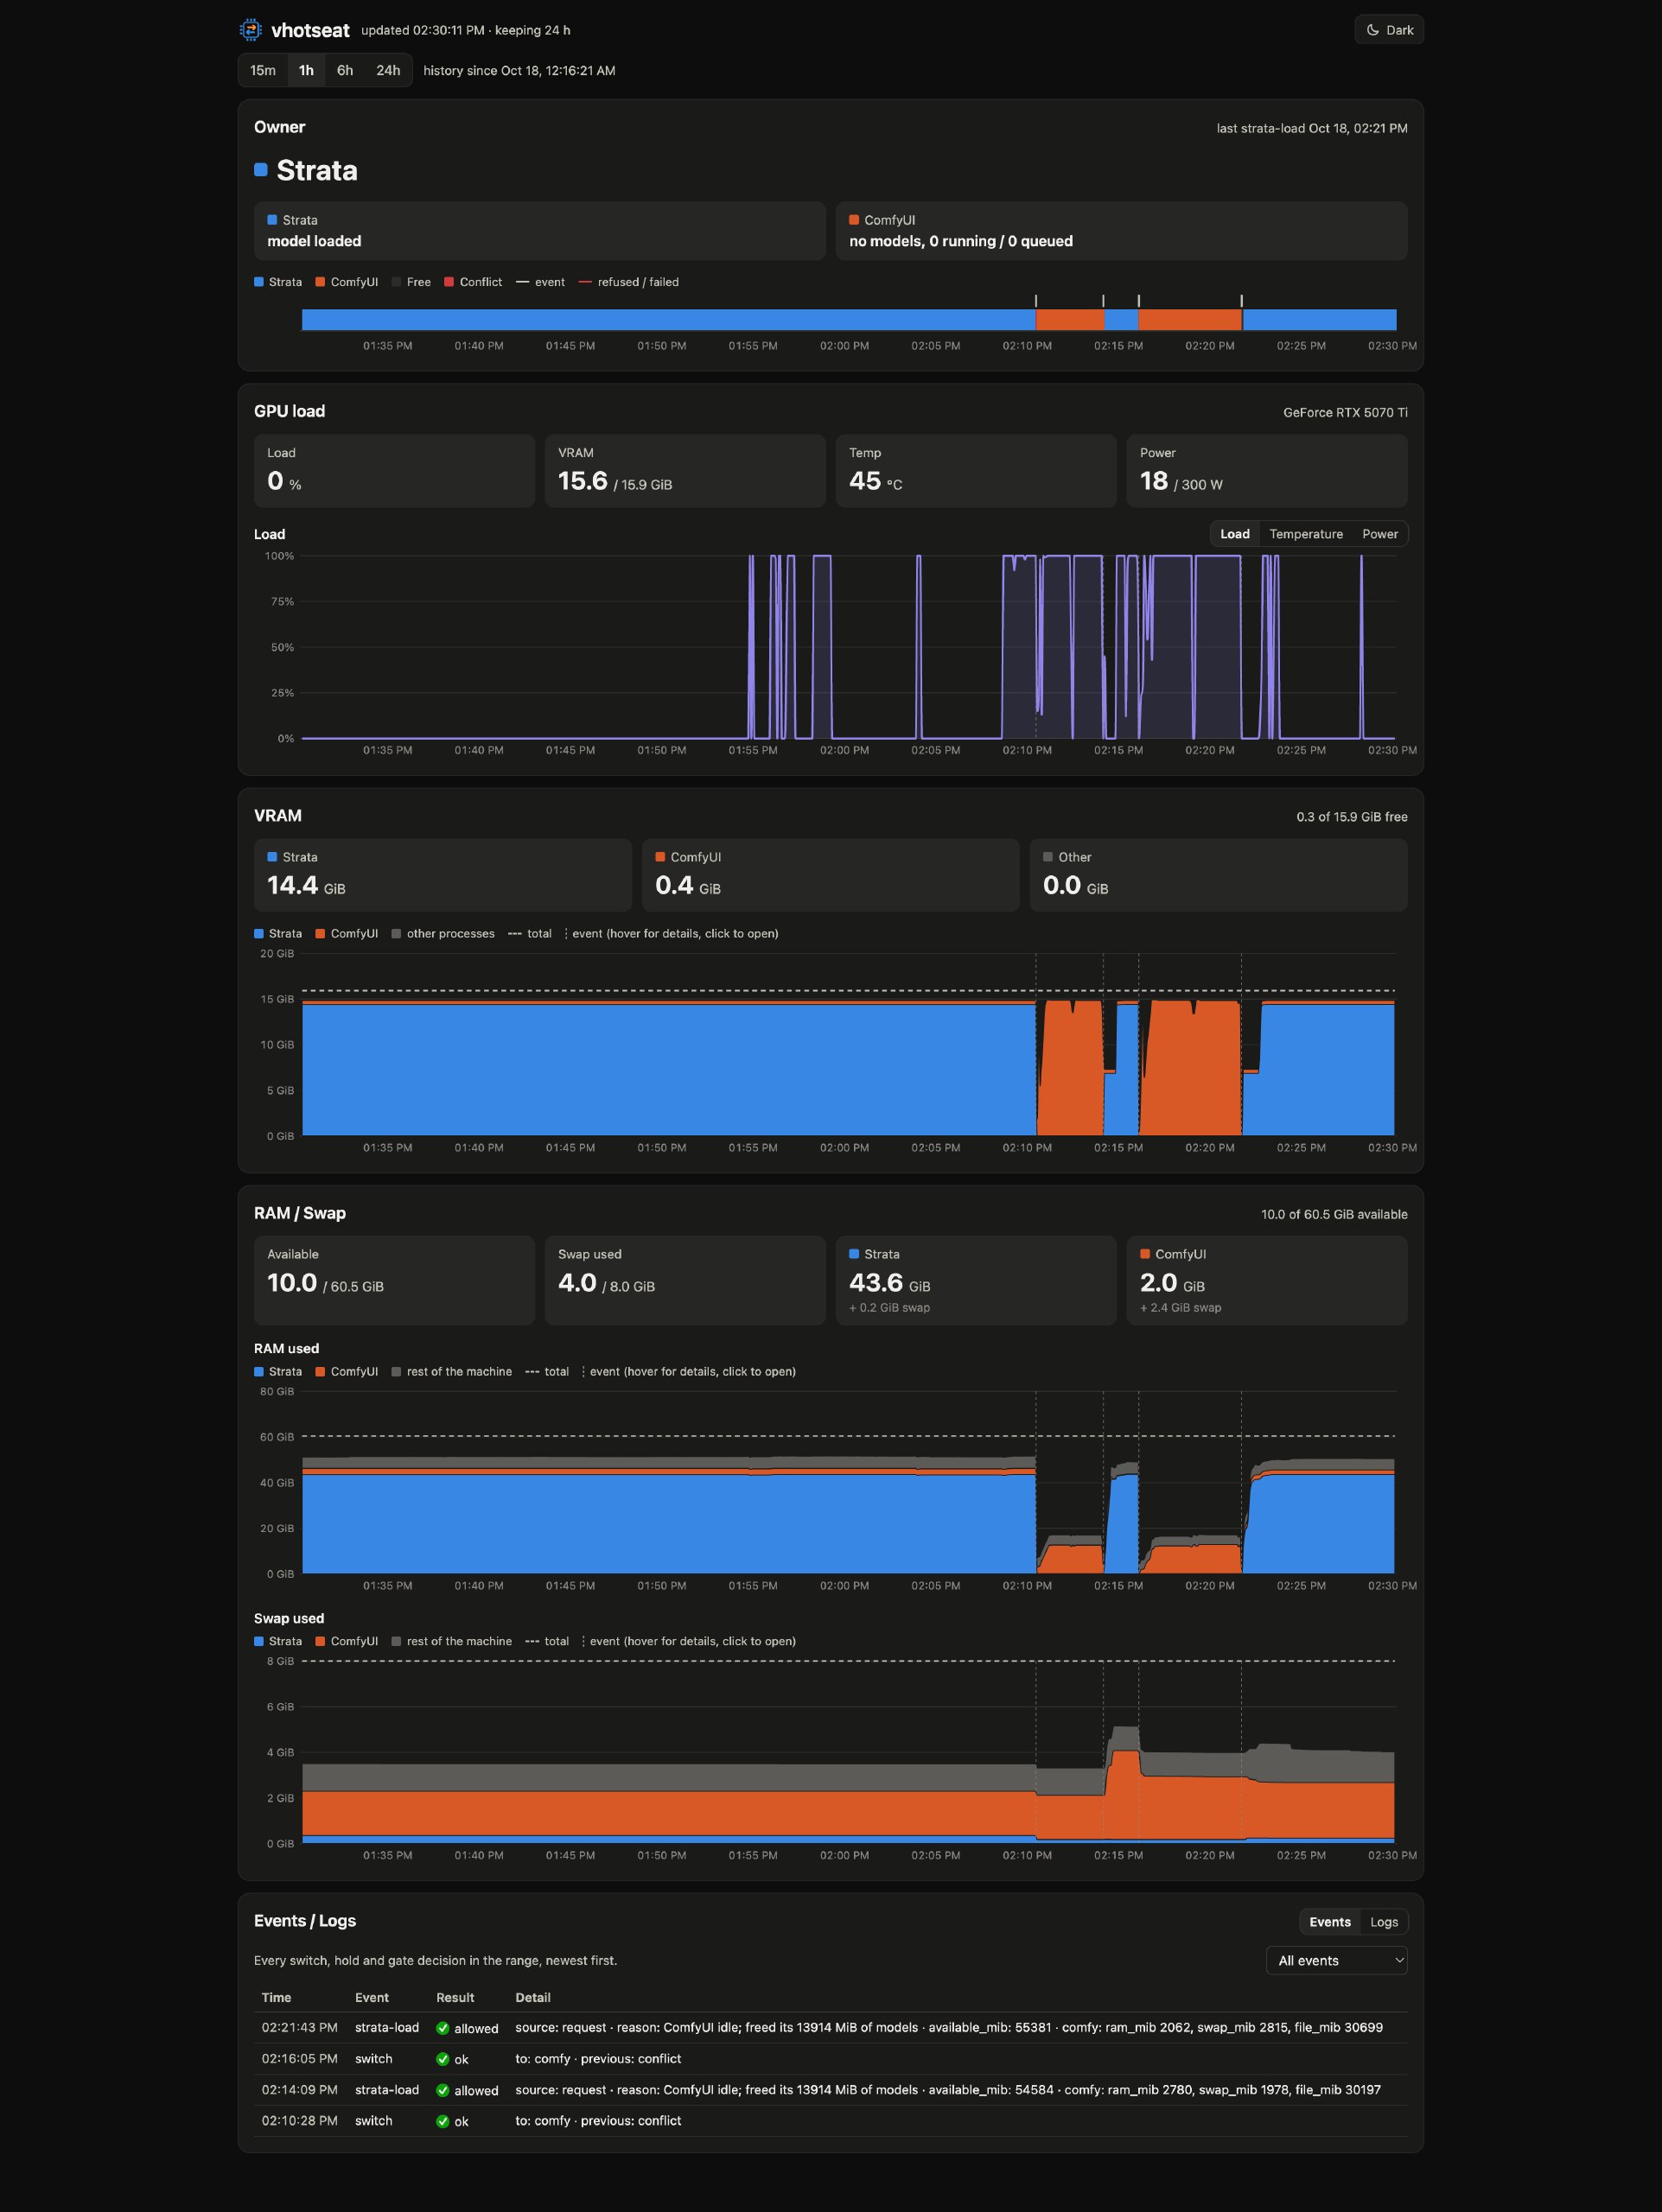
vhotseat unloads a local LLM when ComfyUI needs to render, and switches back when the LLM needs the GPU, to prevent out-of-memory errors. Its `comfy-render` CLI supports batch workflows that reduce GPU handovers. The tool is released under the MIT License, with a quickstart guide for different server configurations.
Surjo-Image-Preview — текстово-графическая модель на архитектуре Looped DiT с 108 млн параметров, обученная с нуля методом rectified flow matching. Генерирует изображения 256×256: лучше справляется с объектами и атрибутами, хуже — с их расположением; глаголы и точный счёт почти не удаются. Текст рисует плохо, лица и руки ломаются вне распределения, подписи поддерживает только на английском.
Это финальные веса превью. Полный релиз обещают с большим набором данных и доработанной архитектурой. Автор советует использовать компактную и быструю модель для черновиков композиции, цвета и настроения, а также для пакетной генерации плейсхолдеров, фонов, текстур, тайлов и мудбордов, когда скорость и цена важнее финального качества.
This open-source tool generates normal maps for pixel art, including static and animated sprite sheets. It runs locally as a CLI or in the browser via WebAssembly.
Out of Pixkrieg is a free browser prototype built with Rust, WebAssembly, TypeScript, and wgpu rendering. Its units have distinct appearances and manageable loadouts, while a shared five-step color palette ties together units, structures, and terrain.
The AI-assisted development process builds on two earlier MIT-licensed tools: Procedural Pixel Creatures and a procedural terrain generator and painter.
The co-op RPG team built standalone World Studio and Asset Studio editors for dressing areas with prop-placement rules. A headless screenshot tool and map-art preview let AI agents visually check game changes.
Other tools include a lag simulator with scripted bot clients, URL review flags for previewing effects in the live game, and a local admin dashboard for player activity, bug reports, and errors.
A fishing and exploration game developer uses Opus 5.5 in a manager session to track development decisions, the OpenAI API for images, ElevenLabs for sound effects, TripoAI for 3D models, and Blender MCP for simpler modeling tasks. The workflow includes the creation of an item called “Ship in the Bottle.”
A functional sandbox RPG demo built with Godot and Claude Opus 5.5 includes NPC routines, dynamic weather, day-night cycles, and a custom interface for dialog interactions and game systems.
A comparison for a pixel-art co-op castle defense game brings together 50 clips and evaluates AI-driven sprite sheets, puppet rigs, motion capture, and traditional animation based on practical experience.
The author’s workflow generates a 3D model from an image, imports it into Godot, and uses Claude Opus to refine it and add details. The approach aims to improve model detail and accuracy.
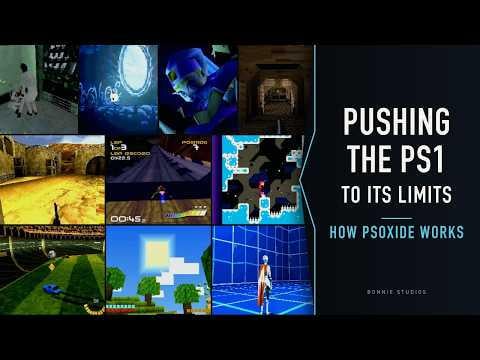
PSoXide is an open-source Rust toolkit for developing games for the original PlayStation. Its engine can interface directly with console hardware components; source code and guides are available, along with a browser-playable demo disc featuring multiple titles.
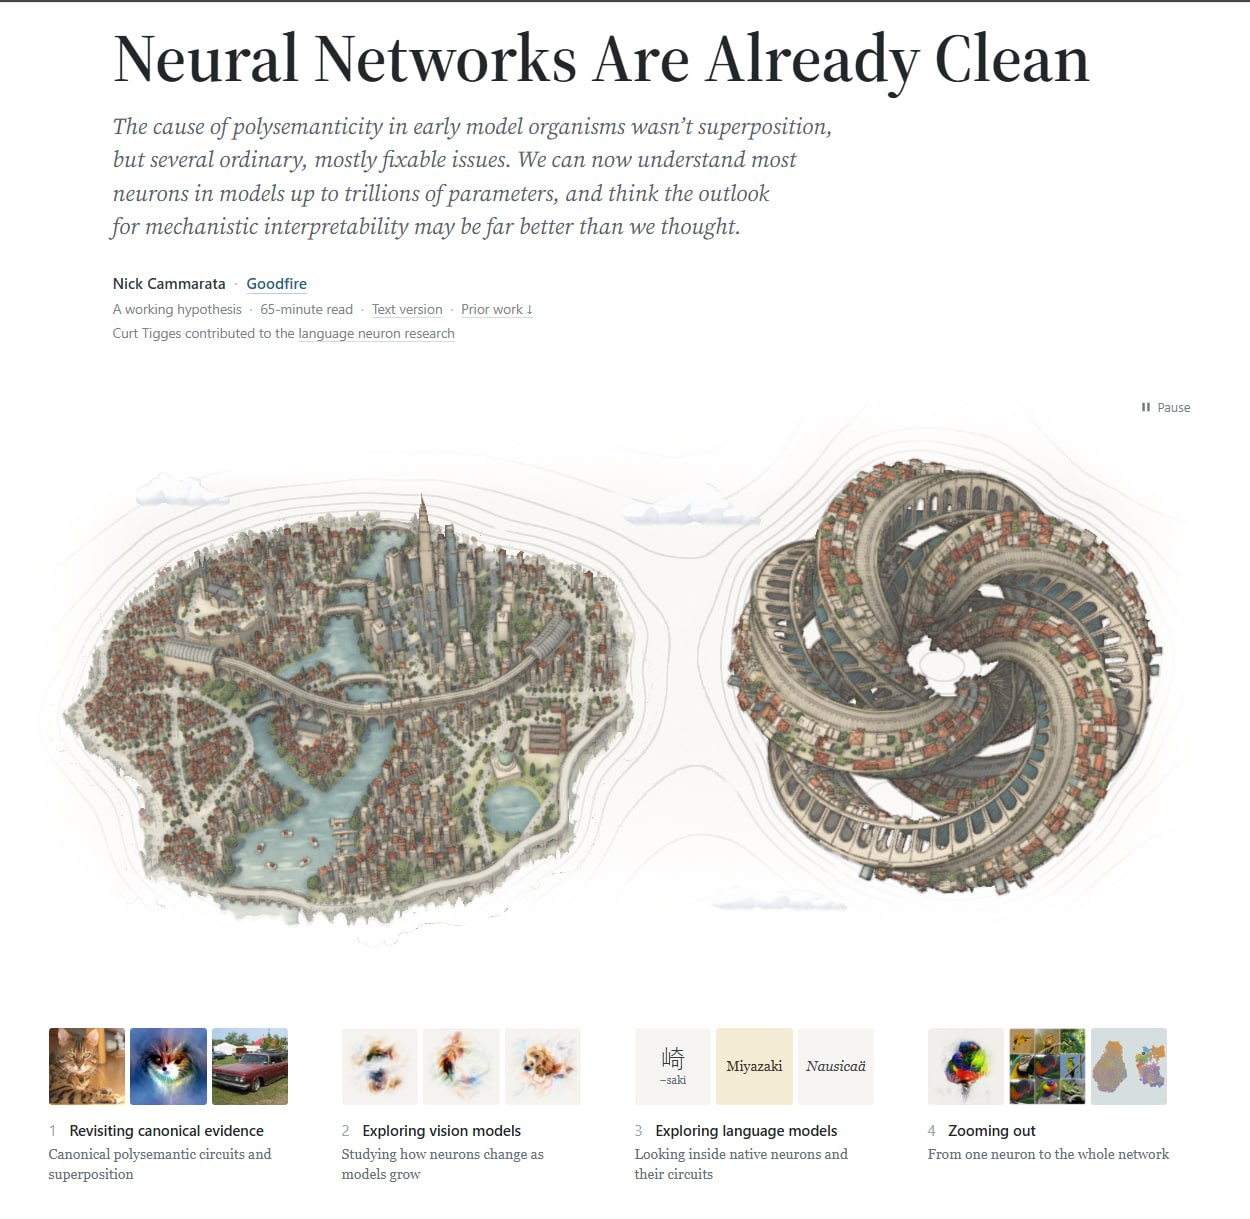
Ник Каммарата вернулся к старым примерам, из-за которых нейроны считали смешивающими несвязанные понятия. По его разбору, нейрон «кошки и машины» реагирует на V-образную форму усов и решётки радиатора. А путаница в поздних слоях InceptionV1 была сбоем обучения: после обычных правок архитектуры читаются 99–100% нейронов этого слоя.
Для Qwen3-32B Каммарата приводит другую картину: у 90% нейронов одна основная задача, у 7% — две связанные, и лишь 2–4% пока непонятны. То, что выглядело смесью понятий, может быть ветвлением: реакция на «iy» развивается в «diy», затем в «do it yourself». Вывод Каммараты — сети можно изучать напрямую; он считает это хорошей новостью для контроля над поведением моделей.
DBS (Dynamic Band Splitting) от Tsinghua подстраивает границы частотных полос под каждый микс при фиксированном бюджете токенов. Метод предсказывает границы по содержимому частотных блоков, выбирает заданное число через hard Top-K и собирает полосы в компактные токены. После разделения токены сглаживаются, возвращаются на сетку STFT, уточняются по частоте и декодируются в комплексные маски общей по частоте головой.
Есть две версии: DBS-BSRNN — 4.7M параметров и окна по 3 секунды; DBS-TIGER — 1M и окна по 6 секунд. Обе разделяют монодорожку 44.1 кГц на музыку, звуковые эффекты и речь. BSRNN тяжелее и аккуратнее на коротких окнах, TIGER компактнее и охватывает больший промежуток времени.
Grok Voice 3.0 слушает речь и отвечает голосом без промежуточного текста. Заявленное время отклика — меньше секунды. Модель уже используют в автомобилях Tesla и поддержке Starlink: она обрабатывает 20 тысяч звонков в день и закрывает около 70% без участия человека — от проверки клиента до отправки замены оборудования.
Доступ открыт через Voice Agent API по 8 центов за минуту, как у предыдущей версии. Русский язык не поддерживается. По оценке автора, модель подходит для автомобилей и техподдержки, но не для сложных разговоров.
Audiobook Studio на базе Qwen делает из EPUB аудиокнигу и EPUB с аудиослоем. Есть автоматический режим: система находит персонажей, определяет их характер, возраст и акценты и собирает озвучку. В полуавтоматическом режиме персонажей можно поправить. Через Telegram-бота можно отправить EPUB и получить ссылку на результат в Google Drive.
Озвученный EPUB подсвечивает текст по предложениям во время чтения; для него нужна читалка с поддержкой такого формата. Программа работает только на ARM, нужен ключ Ollama или DeepSeek. Её тестировали на DeepSeek 4.1 Flash. На M2 Pro с 16 ГБ указана скорость около 1–1,6; обработка книги через API стоит примерно 10–13 центов, Ollama — в рамках тарифа. В примерах использована часовая история.
MOSS-Transcribe-Diarize is reported to outperform larger ASR models and have fewer looping issues than competitors such as VibeVoice-Large. It is available on Hugging Face and compatible with audio.cpp.
Nemotron 3.5 Super VL — модель на 120B параметров для постоянно работающих агентов. Для неё заявлены самое быстрое выполнение задач и высокая точность в своём классе. Она следует инструкциям, работает с инструментами и многошаговыми процессами, читает веб-страницы, PDF и изображения, включая таблицы, графики и документы с OCR.
Вместе с ней вышли две edge-модели: Bolt 74B-A9B с нативной 2-битной квантизацией помещается в 24 ГБ, а Bolt E4B занимает 4 ГБ и рассчитана на голосовых ассистентов и встроенные интерфейсы на RTX и Jetson.
Harness² от Google меняет окружение агента под новую задачу без переобучения модели. Редактировать можно восемь компонентов: системный промпт, guardrails, память, описания инструментов, субагентов, навыки, скрипты и плагины.
В цикле Propose–Probe–Compose агент предлагает правки, проверяет их на одной задаче, сравнивает запуски и собирает улучшенную конфигурацию. Правильный ответ и внешний проверяющий не нужны: метод опирается на различия в поведении между запусками. Принятые конфигурации и подтверждённые запусками выводы сохраняются в постоянном improvement harness. Есть параллельный и последовательный режимы, исполнители OpenCode и Codex.
Artificial Analysis запустила бенчмарк для decision-моделей вроде Jev. Слабое место почти всех участников — отказ от галлюцинаций: у GLiDE показатель 16.4, у Clef — 4.3, у Celeris-1 — ноль. Модели выбирают вариант, но не всегда отвечают «не знаю», когда это нужно.
leanrea — skill для агента в одном файле на 8 КБ. Он предлагает более простой подход к задачам REA: REA работает как отдельный сервис между агентом и программами для анализа файлов, весит 25 МБ, добавляет больше 200 инструментов и требует настройки. При каждом запросе агенту передаётся описание всех этих инструментов.
leanrea ничего не устанавливает: текст подсказывает, какие команды использовать для Electron, нативных бинарников, Go, Android, WASM, баз данных и веба. В нём есть команды для первого прохода, типичные ошибки и правило отмечать в каждом утверждении, что видно, что выведено, а что неизвестно. Агент запускает обычные утилиты через терминал без промежуточного слоя.
В OpenCode добавили бесплатный доступ к GLM 5.3 Flash с контекстом 200k и открытую Beam от Reflection AI. Beam обучена для агентных задач и кодинга: у неё 501B параметров, из них 23B активных, и контекст 1M. Бесплатно попробовать Beam можно ограниченное время. Обе модели доступны через терминал и десктопную версию.
Microsoft анонсировала MAI-Base-2 — базовую MoE-модель на 2,8 трлн параметров, из которых при запросе активны 80 млрд. Её обучали 38 дней на 16 000 ускорителях Nvidia GB200, используя собственные данные Microsoft и не обучая на ответах чужих моделей.
Мустафа Сулейман заявил на внутренней встрече, что модель сильнее той, на которой построена GPT-5.6, а обучение потребовало четверть вычислений OpenAI. В блоге Microsoft заявляет превосходство над базовыми DeepSeek-V4-Pro-Base, Kimi K3 и Qwen и рост эффективности обучения в 4–12 раз относительно DeepSeek. Сравнение касается моделей после предобучения, а не готовых чат-моделей; MAI-Base-2 ещё проходит второй этап обучения. Независимой проверки результатов пока нет.
DeepSeek-V4.1-Flash-1017 — обновление V4.1-Flash с приростом в рассуждениях, коде, агентных задачах и визуальных бенчмарках. Модель тратит меньше времени на задачу и даёт более короткие ответы. Контекст — 1 млн токенов, цены API не изменились.
В сравнении с Opus 5 результаты составили: DeepSWE v1.1 — 77.0 против 74.0, Automation-Bench — 60.5 против 50.3, Agents' Last Exam — 35.4 против 28.6, Apex Bench — 72.1 против 65.8, Chartography с инструментами — 83.0 против 84.0.
На Terminal-Bench 4.0 модель набрала 42.3 против 51.8, ProgramBench — 29.1 против 37.0, NL2Repo-Bench — 68.2 против 75.3, HLE без инструментов — 42.6 против 56.3.
Space Bunny оказалась ранней версией MiniMax M3.1 Flash. Модель набрала 62% в Automation-Bench, 30% в ALE, 74% в DeepSWE и 91% в BabyVision. По сравнению с M3 она работает втрое быстрее и стоит втрое дешевле.
В API 1 млн входных токенов стоит $0,15, выходных — $0,60. Чтение из кеша стоит $0,015 за 1 млн токенов — в десять раз дешевле входных. Модель доступна через API, подписку M Plan и десктопный MiniMax Code; веса обещают открыть 23 октября. Автор считает, что такая цена подходит для агентных циклов с тысячами дешёвых вызовов.
FreeLLMAPI объединяет бесплатные тарифы 34 провайдеров в один OpenAI-совместимый эндпоинт /v1. В каталоге — 635 бесплатных эндпоинтов и 474 семейства моделей; суммарный доступный объём оценивается примерно в 7,4 млрд токенов в месяц. Роутер выбирает доступную модель для запроса, переключается при исчерпании лимитов, учитывает расход по каждому ключу и хранит ключи в зашифрованном виде. Поддерживаются чат, эмбеддинги, изображения и аудио.
Есть версии для macOS и Windows, Docker и мобильные приложения. Каталог обновляется через подписанный фид без git pull. Сам роутер бесплатный: новые модели появляются через 30 дней либо сразу за $19 в год. Автор канала не рекомендует его для продакшена.
MJev-Spatial превращает пространственный вопрос в выбор из конечного набора кандидатов и отвечает классификацией, без генерации токенов ответа. Модель построена на Qwen3.5-4B и повторно использует её Q/K-проекции для оценки кандидатов. Она показала лучший средний результат на 7 из 12 бенчмарков и работает в 5,6 раза быстрее базовой модели.
В Jev 1.14 от TypeSafe появилась мультимодальность: изображения включаются заголовком TypeSafe-Danger-Zone-Images: true. Добавлены тип box, возвращающий один bounding box, и режим длинного контекста через TypeSafe-Danger-Zone-Long-Context: true. На мультимодальных задачах все модели, включая Jev, работают хуже, чем на чистом тексте.
DigUp — опенсорсный инструмент для глубокого поиска по файлам. Он использует мультимодальную EmbeddingGemma 2 с 740M параметров и весом около 1,5 ГБ. Локально можно искать фото по описанию, сцены в видео и аудио с таймингами, а также работать с документами, музыкой и кодом.
Автор называет DigUp бесплатной безлимитной альтернативой Jockey от TwelveLabs. При этом у Jockey есть поиск сразу по нескольким модальностям, например по кадру и музыке, и нет ограничения на длительность видео; базовый тариф включает 5 ГБ. DigUp доступен на Mac, уже появились бета-версии для Windows и Linux.
OpenCode сообщил о взломе, связанном с масштабной атакой дистилляции. Инцидент затронул 1.4% пользователей OpenCode Console, у которых были привязаны внешние провайдеры. Пострадавших уведомили по почте; по сообщению OpenCode, пользователей, не получивших письмо, инцидент не коснулся.
Инцидент продолжается. Что именно утекло, пока не уточняется; разбор ведут вместе с Anthropic, OpenAI и Google. Автор считает, что формулировка о дистилляции может указывать на попытку выкачать модель через API, и советует пользователям с привязанными провайдерами проверить почту и перевыпустить ключи. В комментариях пользователи спрашивают о списаниях и скомпрометированных ключах.
Timestral — семейство базовых моделей на 5M, 28M, 123M и 209M параметров. Они прогнозируют одномерные и многомерные ряды в режиме zero-shot, без дообучения под конкретный ряд. Поддерживаются ковариаты из прошлого и заранее известные будущие значения. За один проход модель принимает до 32 768 шагов истории и прогнозирует до 1024 шагов.
Для Timestral заявлен SOTA в zero-shot на GIFT-Eval, TIME и fev-bench. Инференс работает через PyTorch на CPU и GPU. Среди применений — прогноз спроса, нагрузки на сети, финансовых и страховых показателей, данных промышленных датчиков, энергетики и медицинского мониторинга.
Photon обслуживает весь поиск Perplexity, заменив открытый движок, который компания годами поддерживала как форк. У прежней системы p99 доходил до 800 мс, а при слиянии индексов — до 1,2 с на 10–15 минут. Индекс не помещался в память, холодные чтения вызывали page faults, а синхронизация нового кластера занимала больше недели.
В Photon сделали компактный перевёрнутый индекс с блоками по плотности и отдельную запись docblob с частотами и позициями. Добавили кэш для пакетных чтений и асинхронный доступ к диску через io_uring. Сборку индекса отделили от выдачи: группу сначала прогревают, затем направляют на неё трафик.
По данным Perplexity, p99 внутри Photon снизился с 800 до 65 мс. Машин требуется на 20% меньше при объёме данных на документ в 2,5 раза больше. Быстрый пресет Search API даёт 160 мс p50 и 230 мс p95; стоимость задачи ниже на 68% при сопоставимом качестве. Над движком работали небольшая команда и рой постоянно действующих кодинг-агентов.